Kinh nghiệm xử lý sự cố Production: Cách kết hợp Metrics, Logs và Traces
Sự cố xảy ra lúc 3 giờ sáng trên môi trường Production khi API
by DuyNCT
2 days ago
[ Kinh nghiệm xử lý sự cố Production (môi trường vận hành thực tế) lúc 3 giờ sáng: Cách kết hợp Metrics, Logs và Traces để tìm ra lỗi Connection Pool Exhaustion (cạn kiệt vùng chứa kết nối) ]
Nguồn: Video "3AM Observability Crash Course (A True Story)" từ kênh YouTube pouria
 41c414d9-35ba-8003-b0e9-d14acf686e30.png
TL;DR:
- Sự cố xảy ra lúc 3 giờ sáng trên môi trường Production khi API
/checkoutbị tăng P99 Latency (độ trễ ở phân vị thứ 99) từ 180ms lên 3.2s và trả về lỗi 504 Gateway Timeout (hết thời gian chờ tại cổng giao tiếp) cho 0.4% lượng request (yêu cầu). - Áp dụng tư duy khoanh vùng "Wolf Fencing" (rào sói) đi từ Metrics trên Prometheus/Grafana sang Logs trên Filebeat/Elasticsearch và cuối cùng là Distributed Tracing (truy vết phân tán).
- Tìm ra nguyên nhân gốc rễ không phải do quá tải CPU hay spike traffic (lưu lượng tăng đột biến) ở Order Service (dịch vụ đơn hàng), mà do Inventory Service (dịch vụ kho hàng) mất tới 2,962ms chỉ để chờ lấy connection (kết nối) từ PostgreSQL Connection Pool (vùng chứa kết nối cơ sở dữ liệu) do lỗi Connection Leak (rò rỉ kết nối) làm toàn bộ 20 kết nối bị chiếm giữ không được giải phóng.
 41c414d9-35ba-8079-bd57-e00f158f821c.png
Chắc anh chị em làm hệ thống Microservices (kiến trúc vi dịch vụ) đều ít nhất một lần trải qua cảm giác đang ngủ ngon lúc 3 giờ sáng thì bị PagerDuty (công cụ cảnh báo trực chiến) dựng dậy vì cảnh báo đỏ trên Production. Hôm nay mình xem được một video từ kênh pouria mô phỏng lại toàn bộ quy trình điều tra sự cố rất sát với thực tế, đặc biệt là cách kết nối ba trụ cột của Observability (khả năng quan sát hệ thống) gồm Metrics, Logs và Traces để tìm ra bottleneck (điểm nghẽn cổ chai) ẩn sâu trong hệ thống.
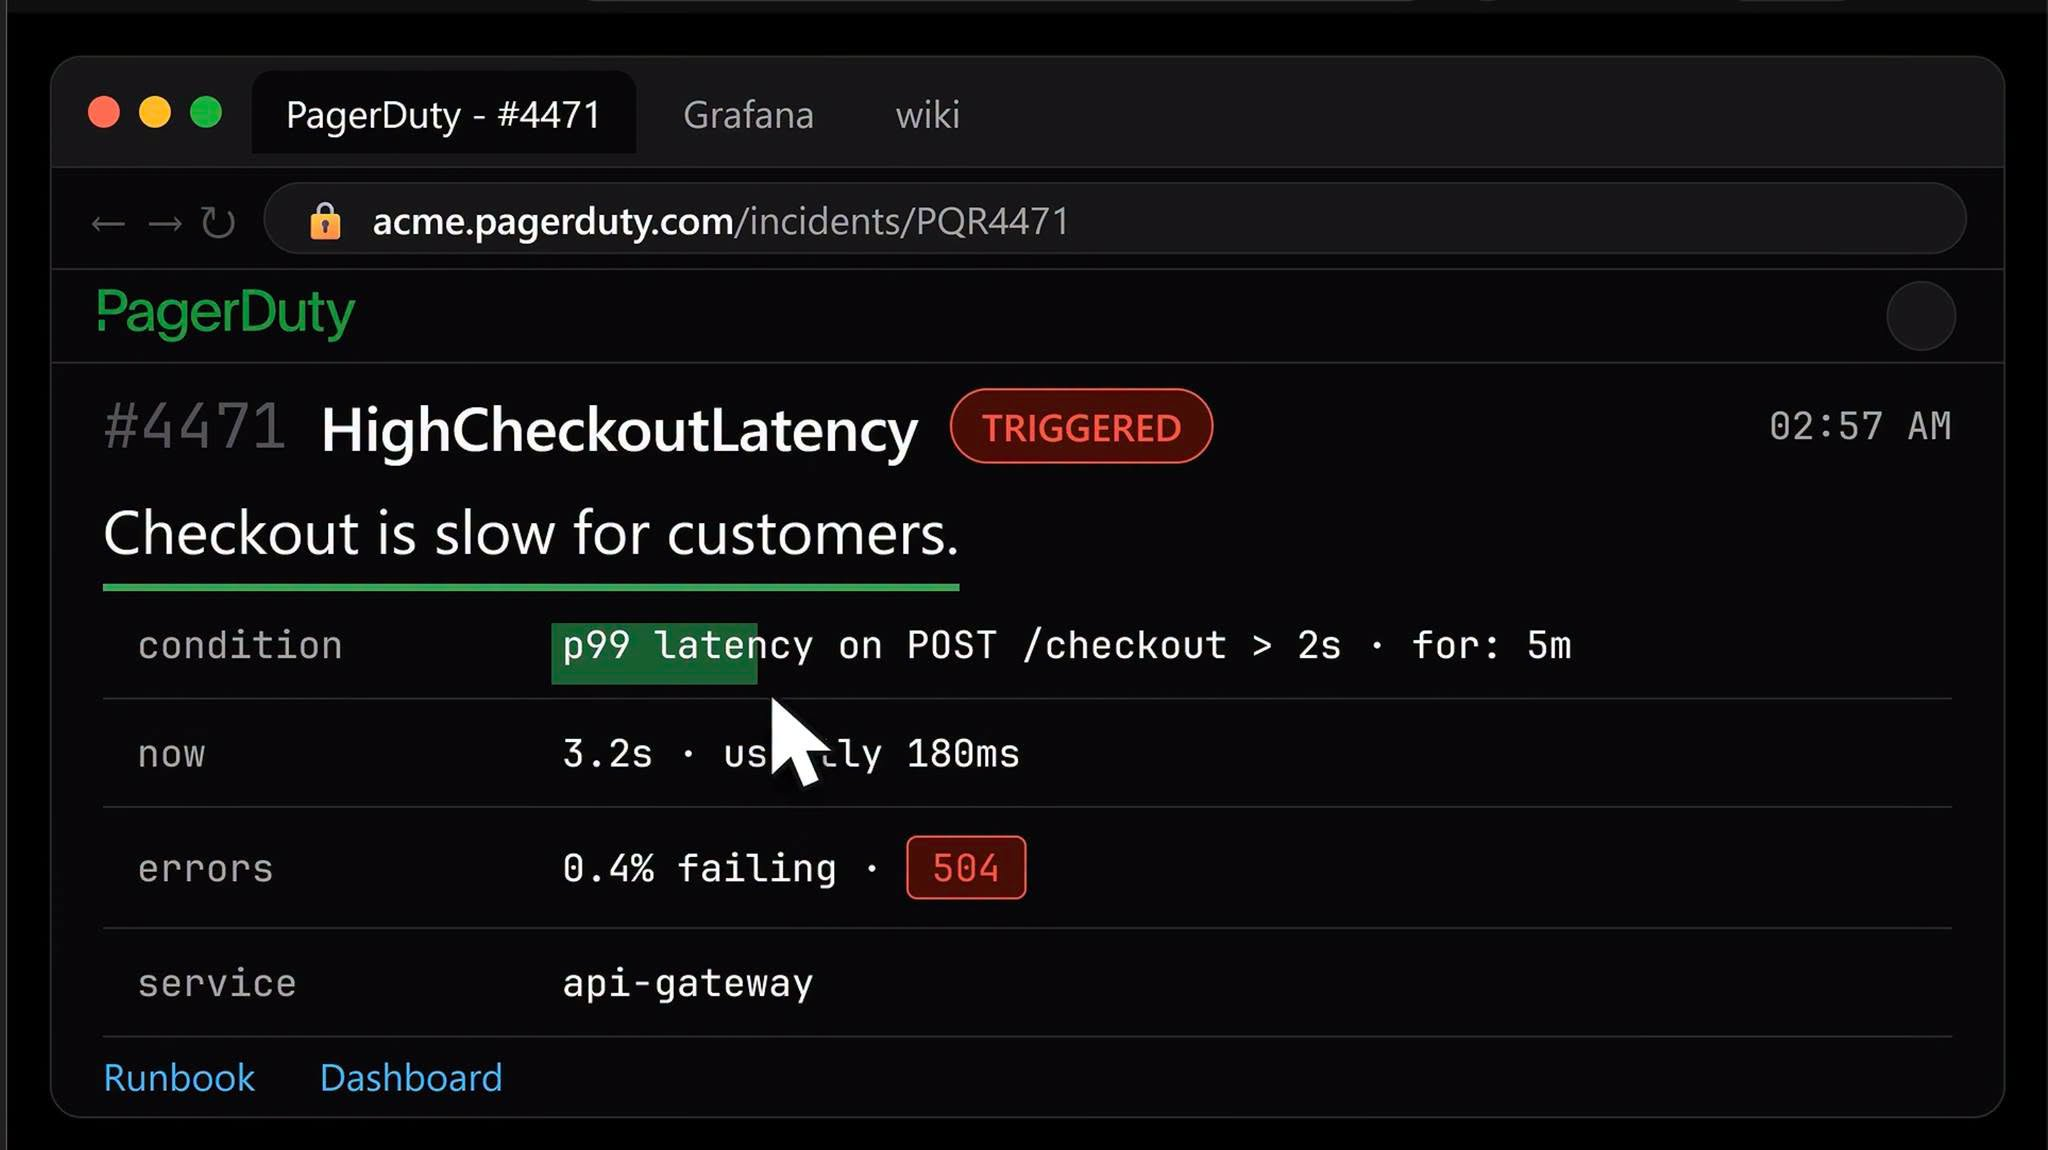
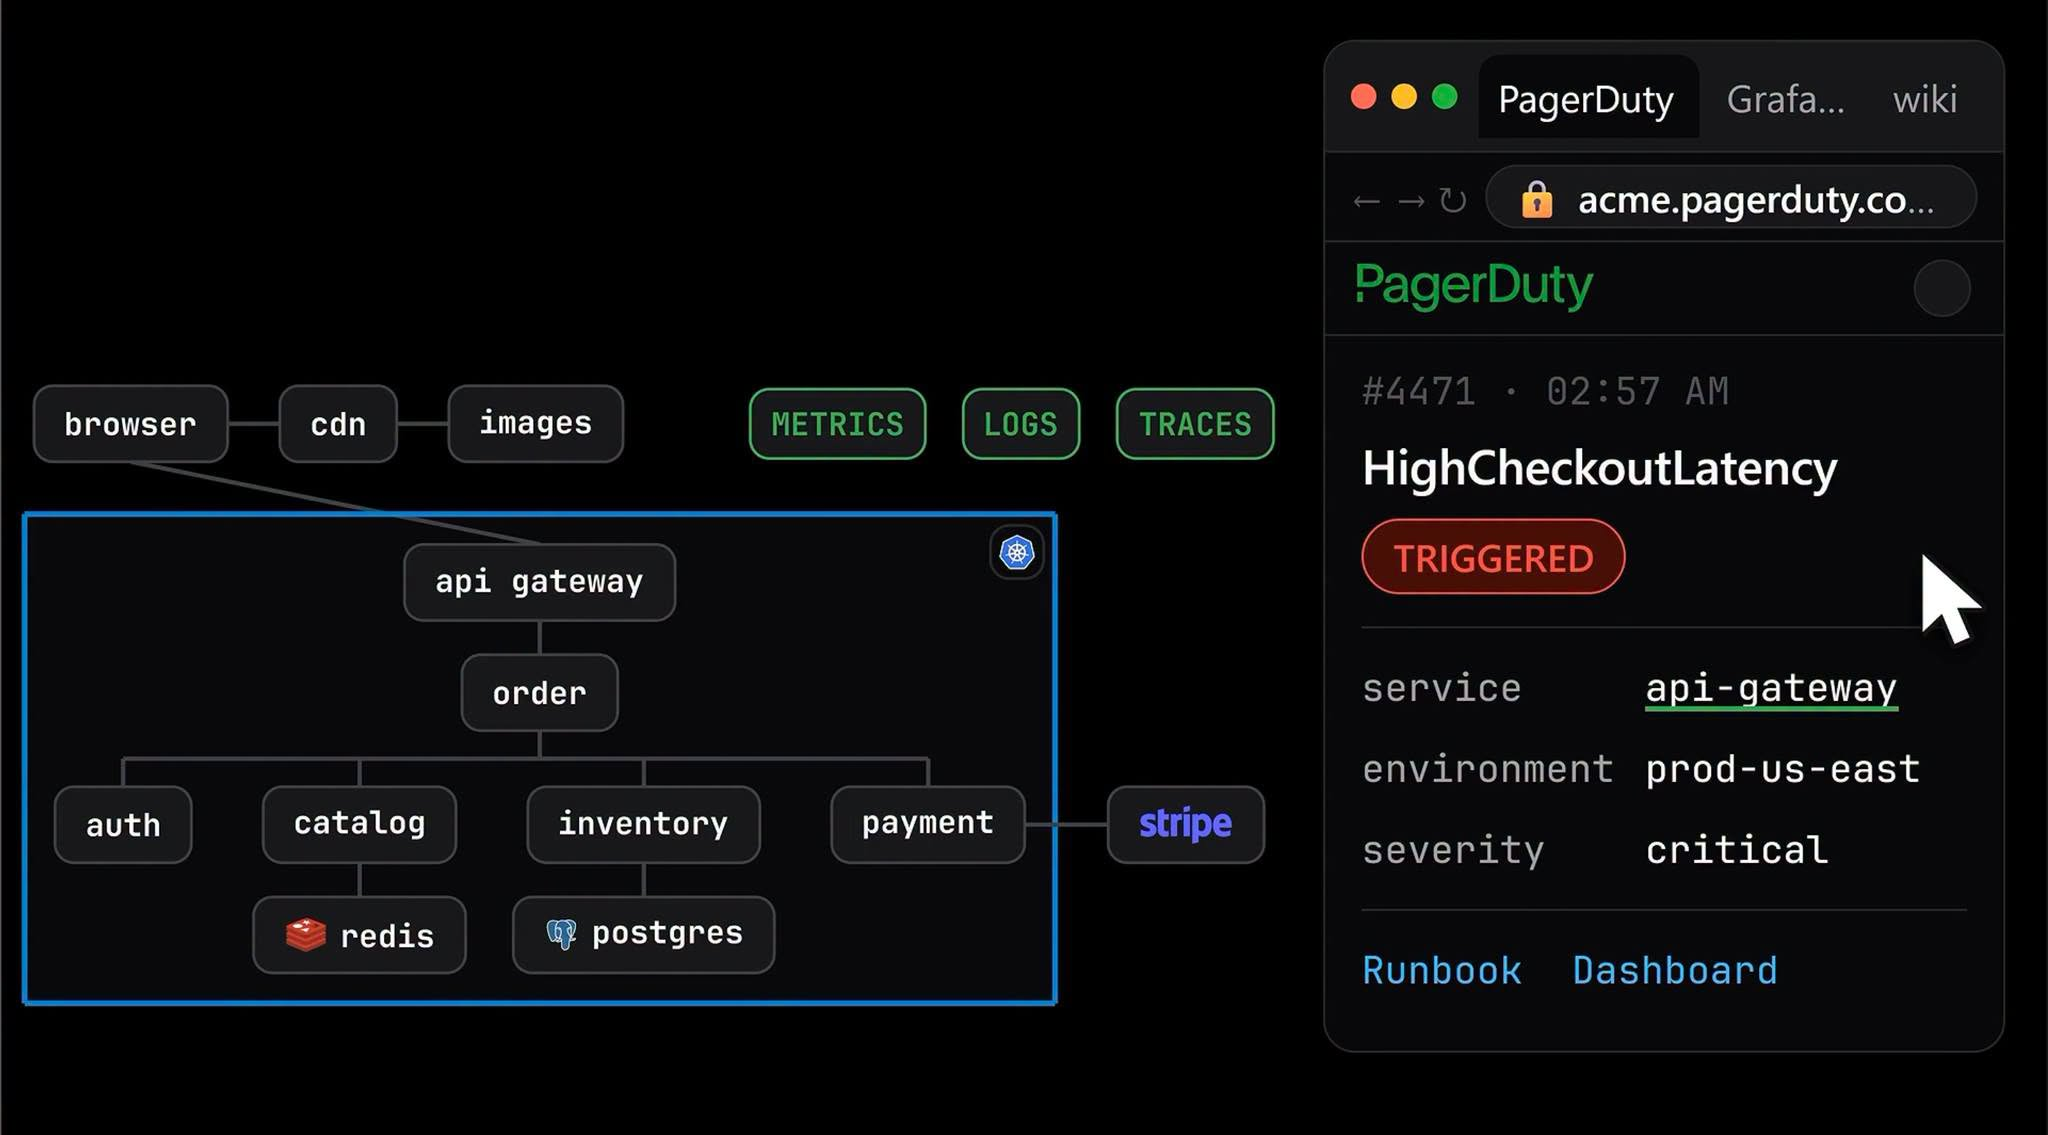
Câu chuyện bắt đầu bằng một cảnh báo nghiêm trọng: P99 Latency (nghĩa là 99% tổng số request xử lý nhanh hơn mốc này, chỉ có 1% chậm hơn) của luồng POST /checkout tại tầng API Gateway (cổng giao tiếp API) vọt lên trên 2 giây liên tục trong 5 phút. Bình thường một request thanh toán chỉ mất khoảng 180ms, nhưng lúc xảy ra sự cố thì vọt lên tới 3.2s, kéo theo 0.4% lượng request bị đứt gánh với mã lỗi 504 Gateway Timeout. Với anh chị em làm backend (hệ thống phía máy chủ) thì nhìn thấy 504 ở API Gateway là biết ngay bản thân con Gateway không bị lỗi, mà nó đang đứng chờ một downstream service (dịch vụ hạ nguồn/phía sau) nào đó phản hồi quá lâu.
 41c414d9-35ba-80ef-ac98-c54579ebb109.png
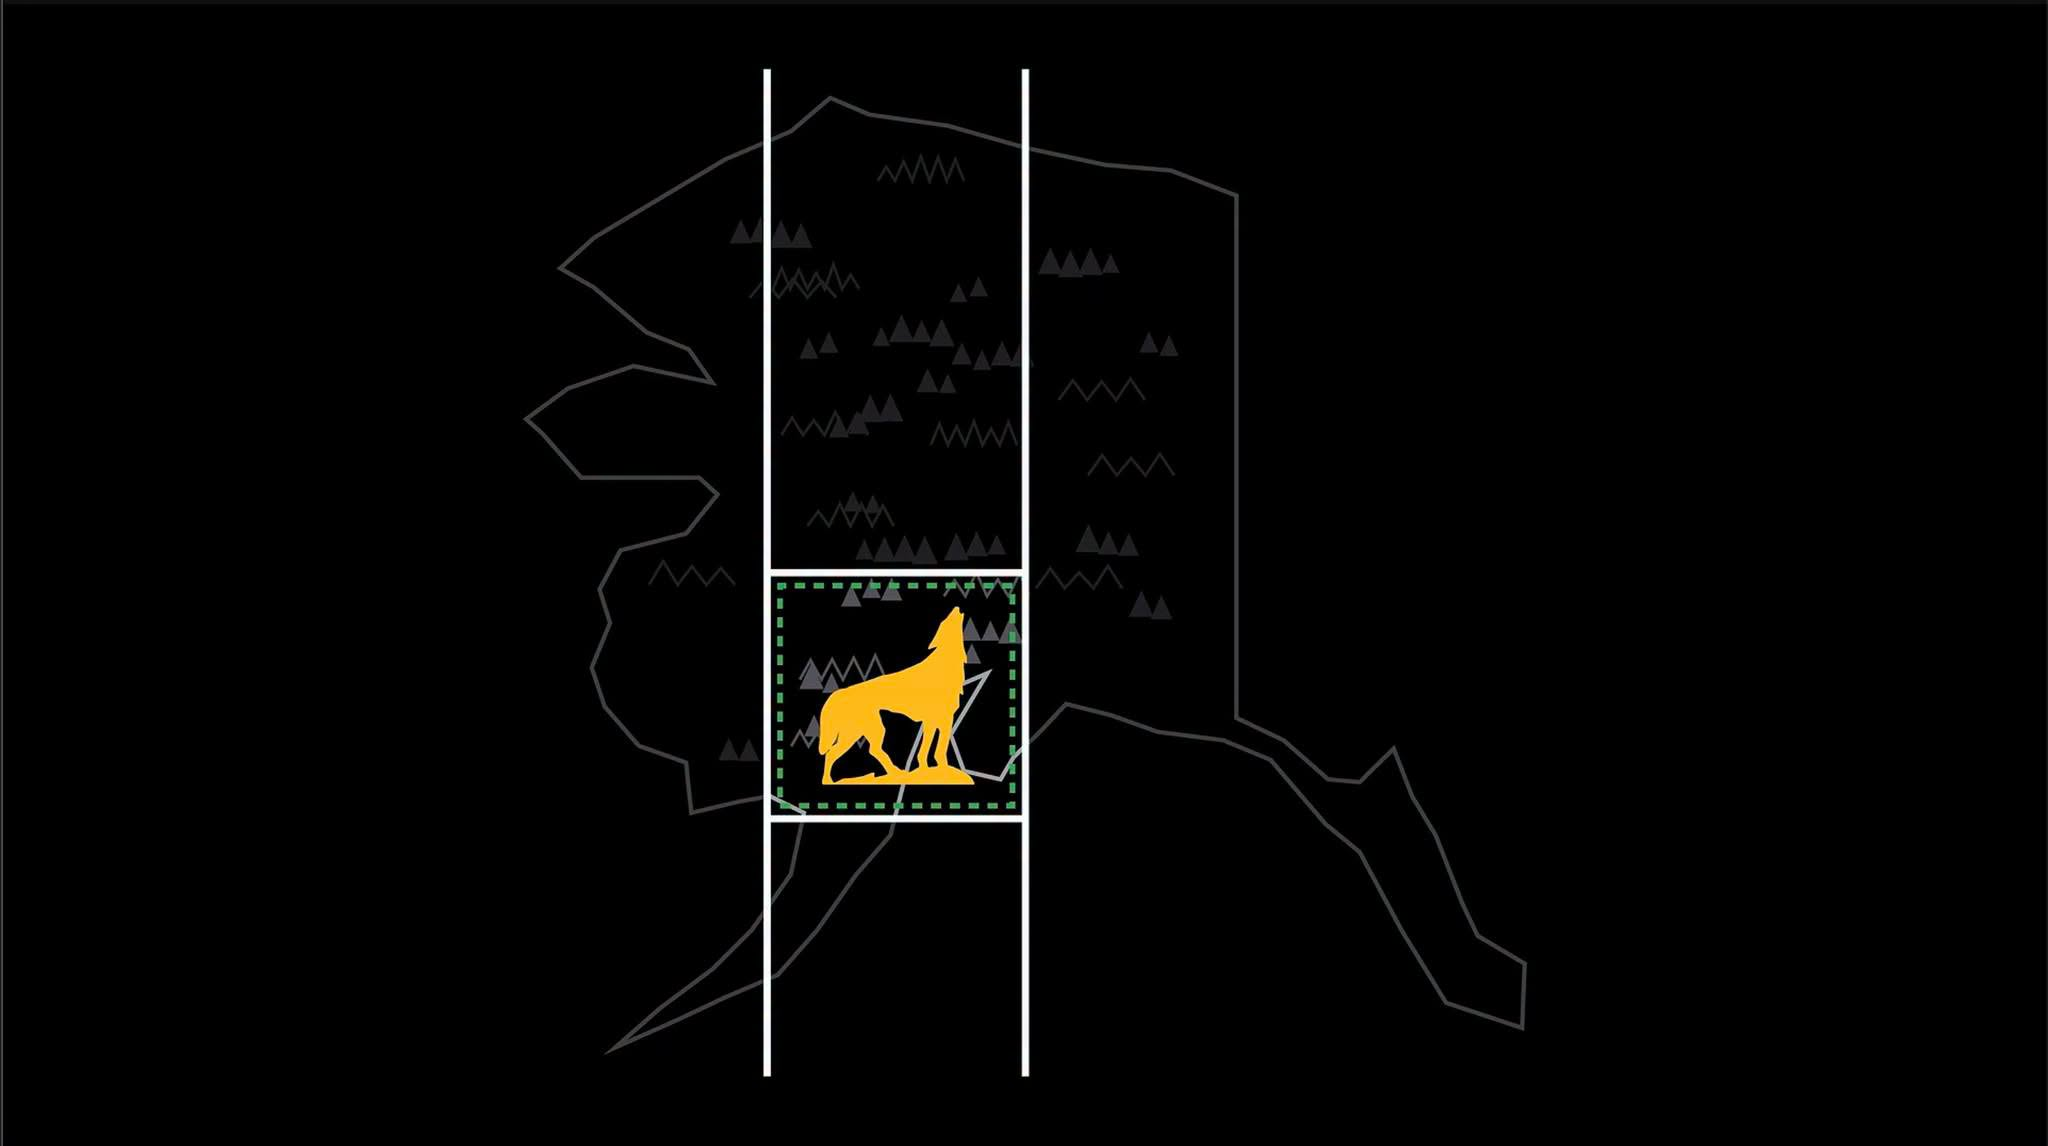
Để không bị loạn giữa hàng chục Microservices đang gọi chéo nhau, video nhắc lại một tư duy kinh điển trong debugging (gỡ lỗi) gọi là "Wolf Fencing". Muốn tìm một con sói giữa bang Alaska rộng lớn, người ta dựng một hàng rào cắt đôi bang, lắng nghe tiếng sói hú để biết nó ở nửa nào, rồi lại tiếp tục chia đôi vùng đó cho đến khi tóm được nó. Khi xử lý sự cố Production cũng vậy, chúng ta dùng các công cụ Observability để dựng từng lớp rào thu hẹp phạm vi tìm kiếm.
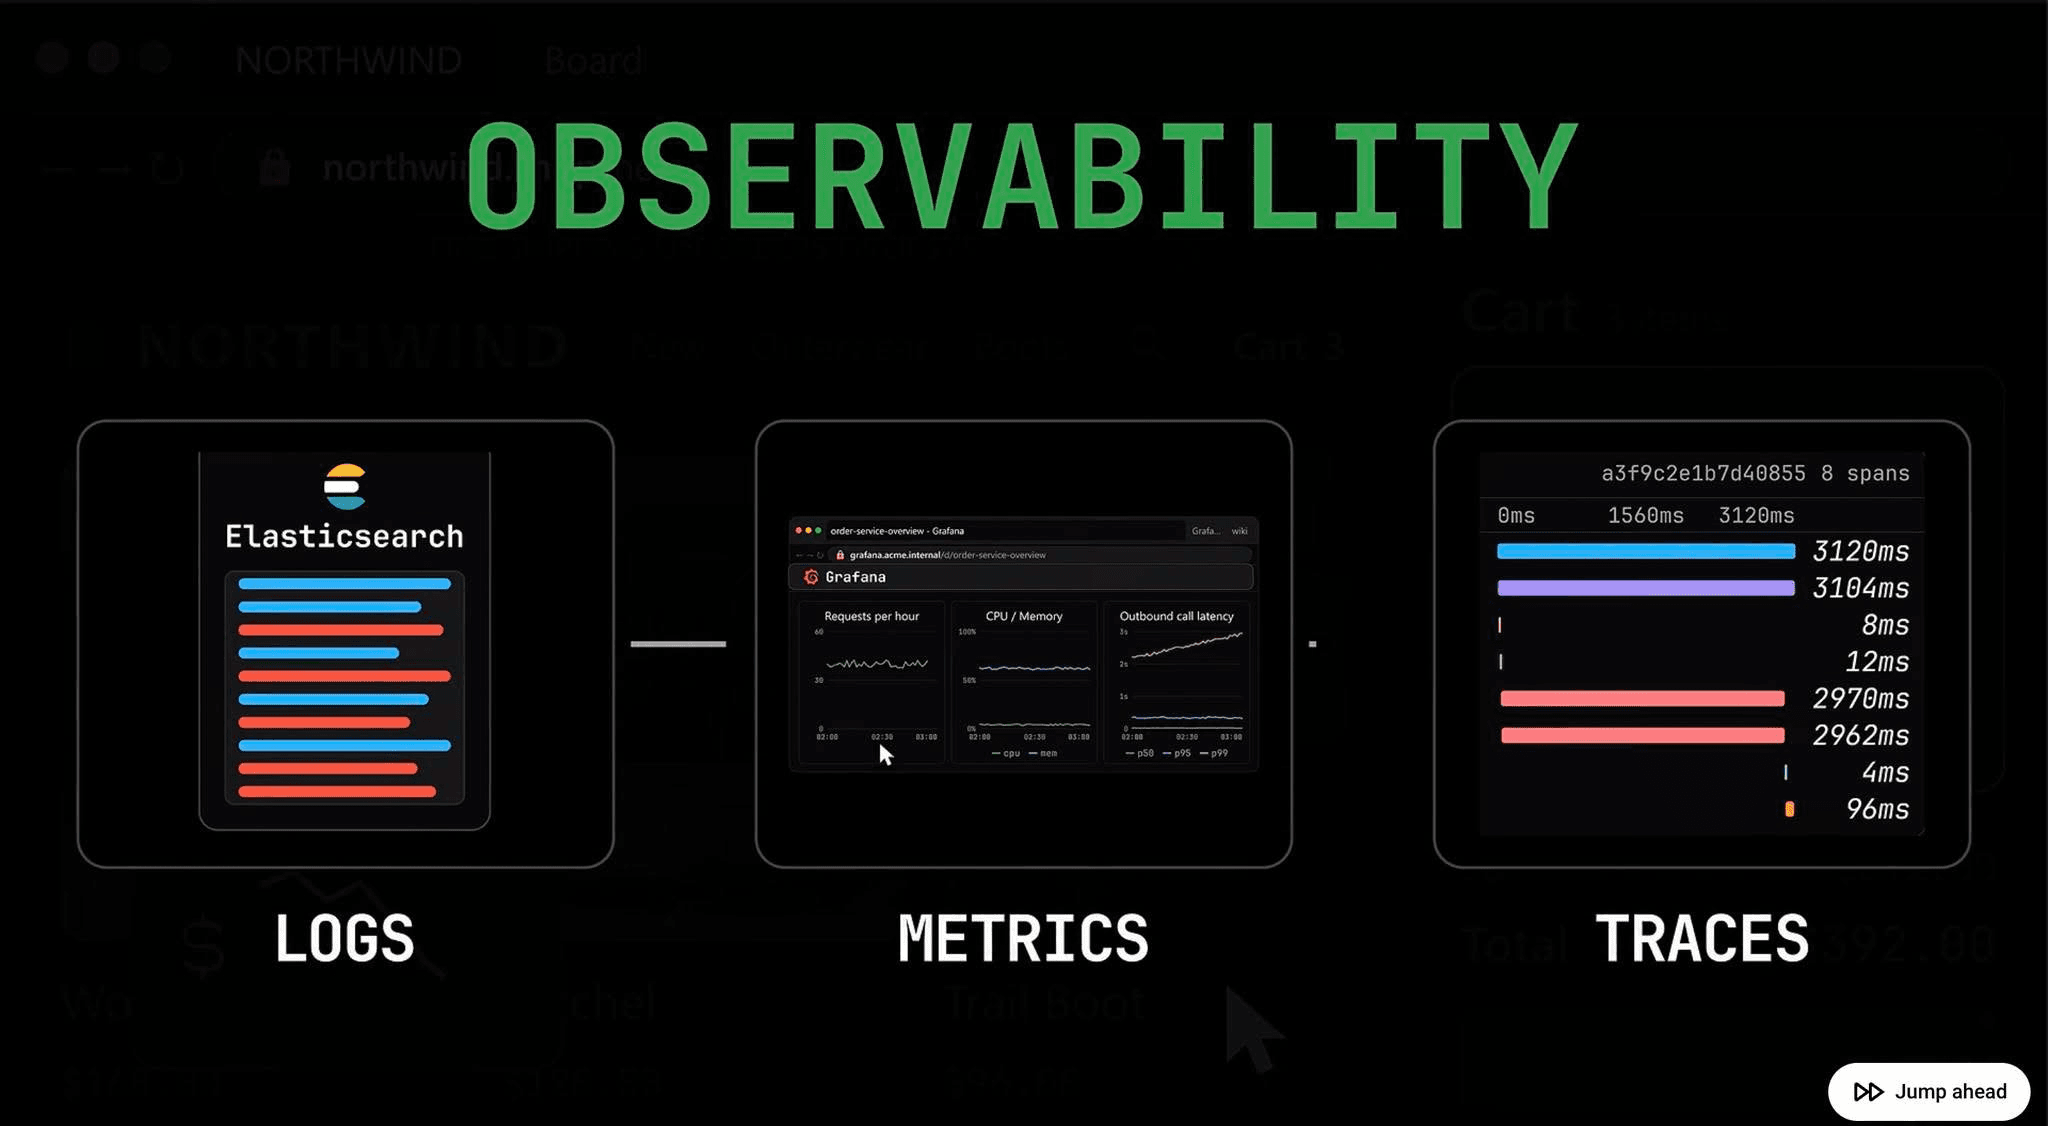
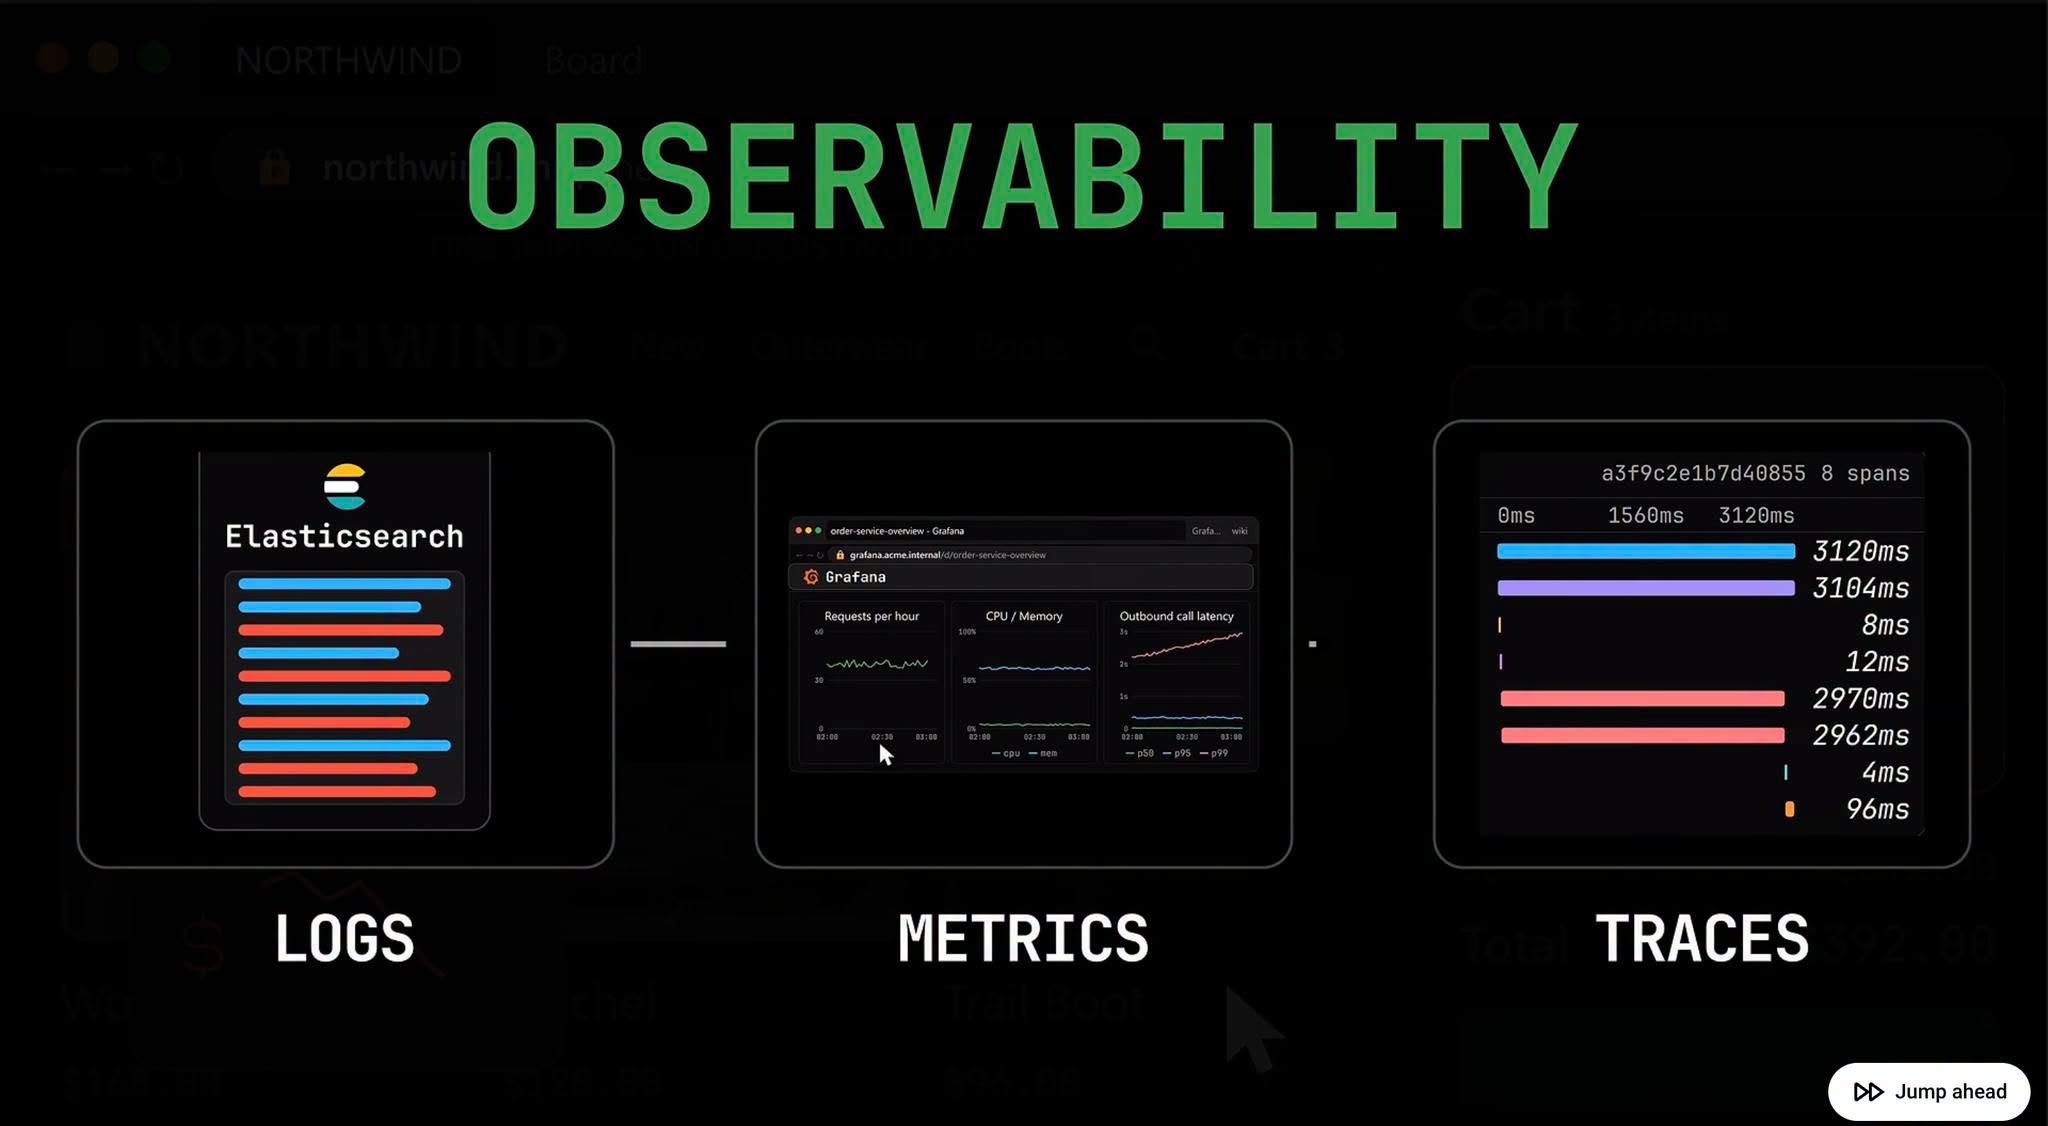
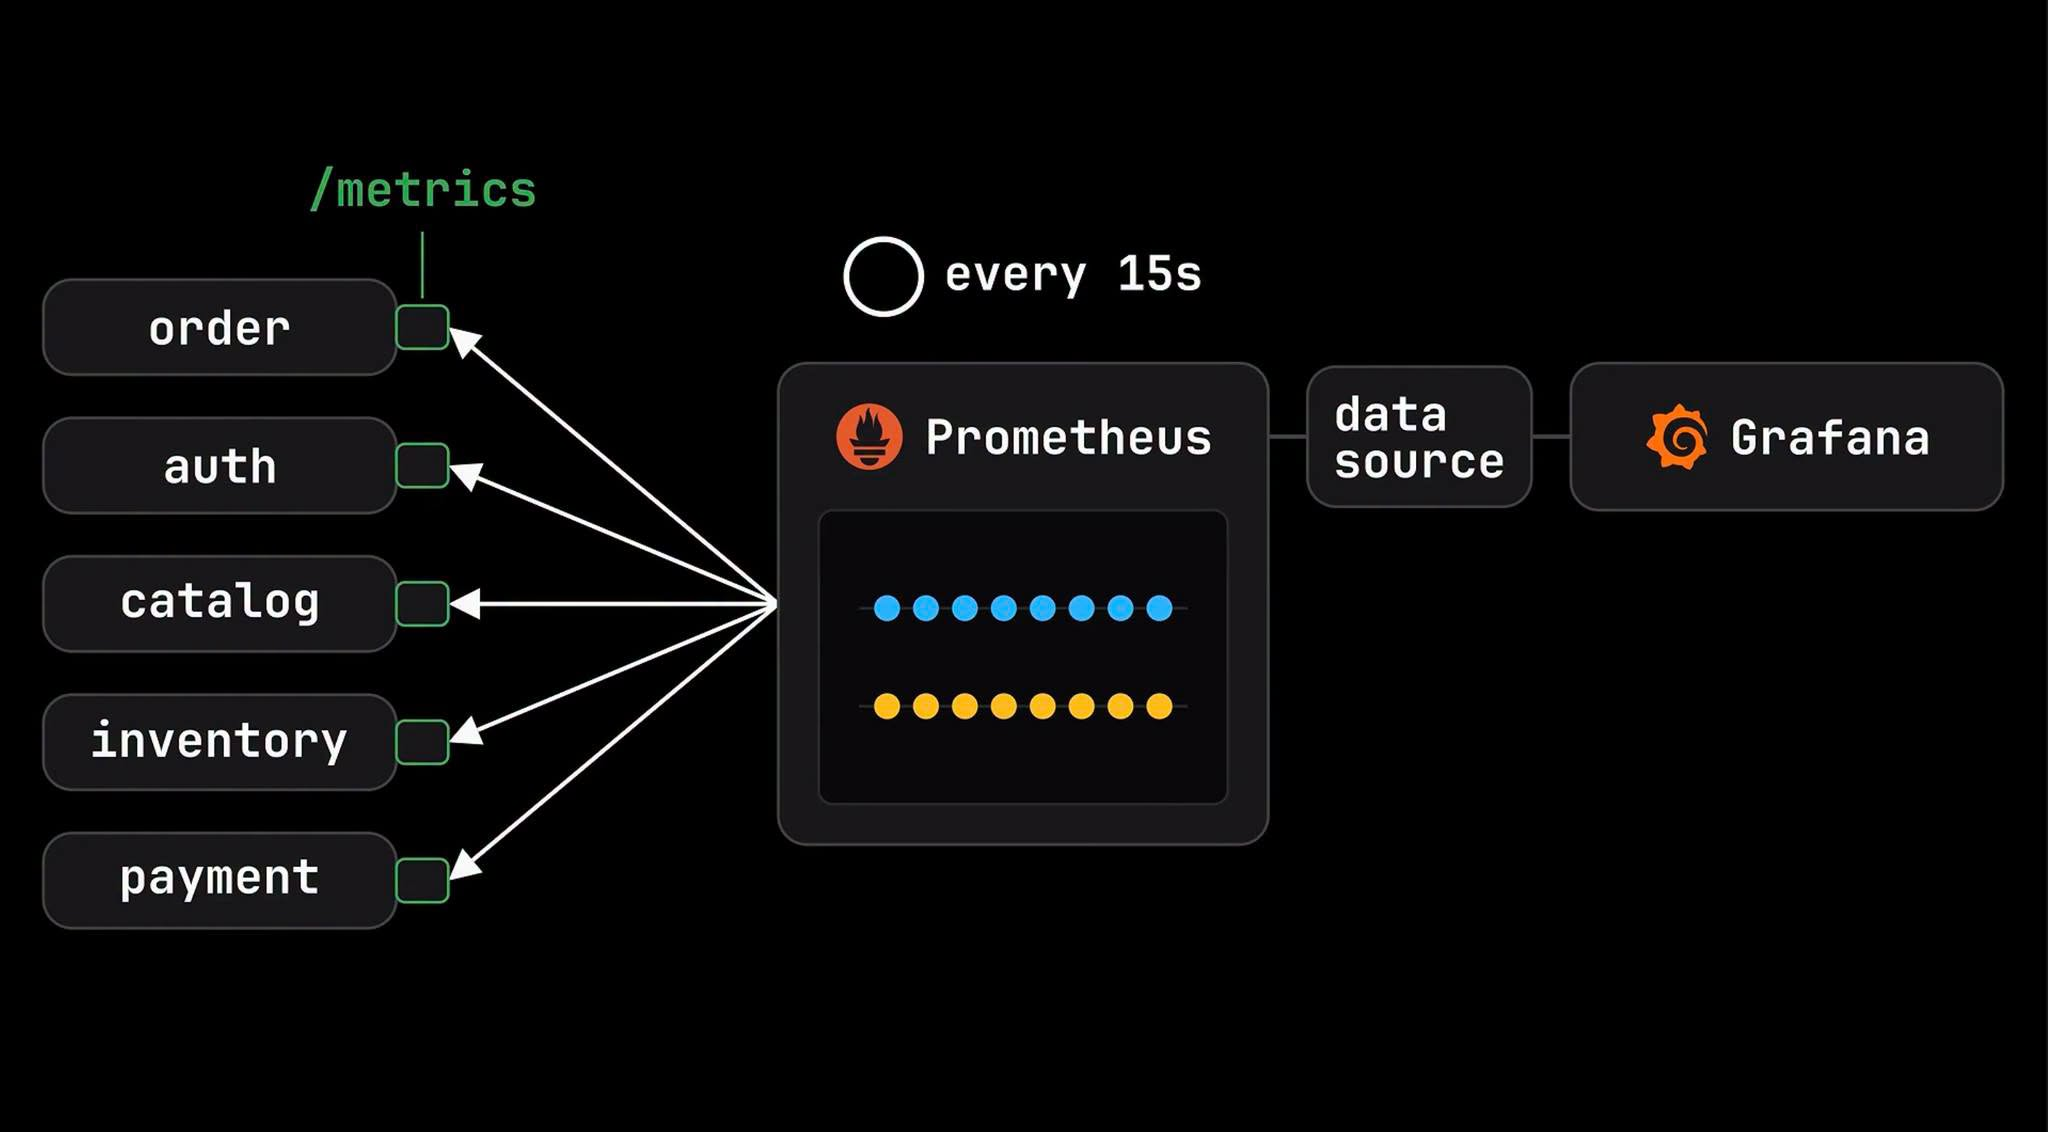
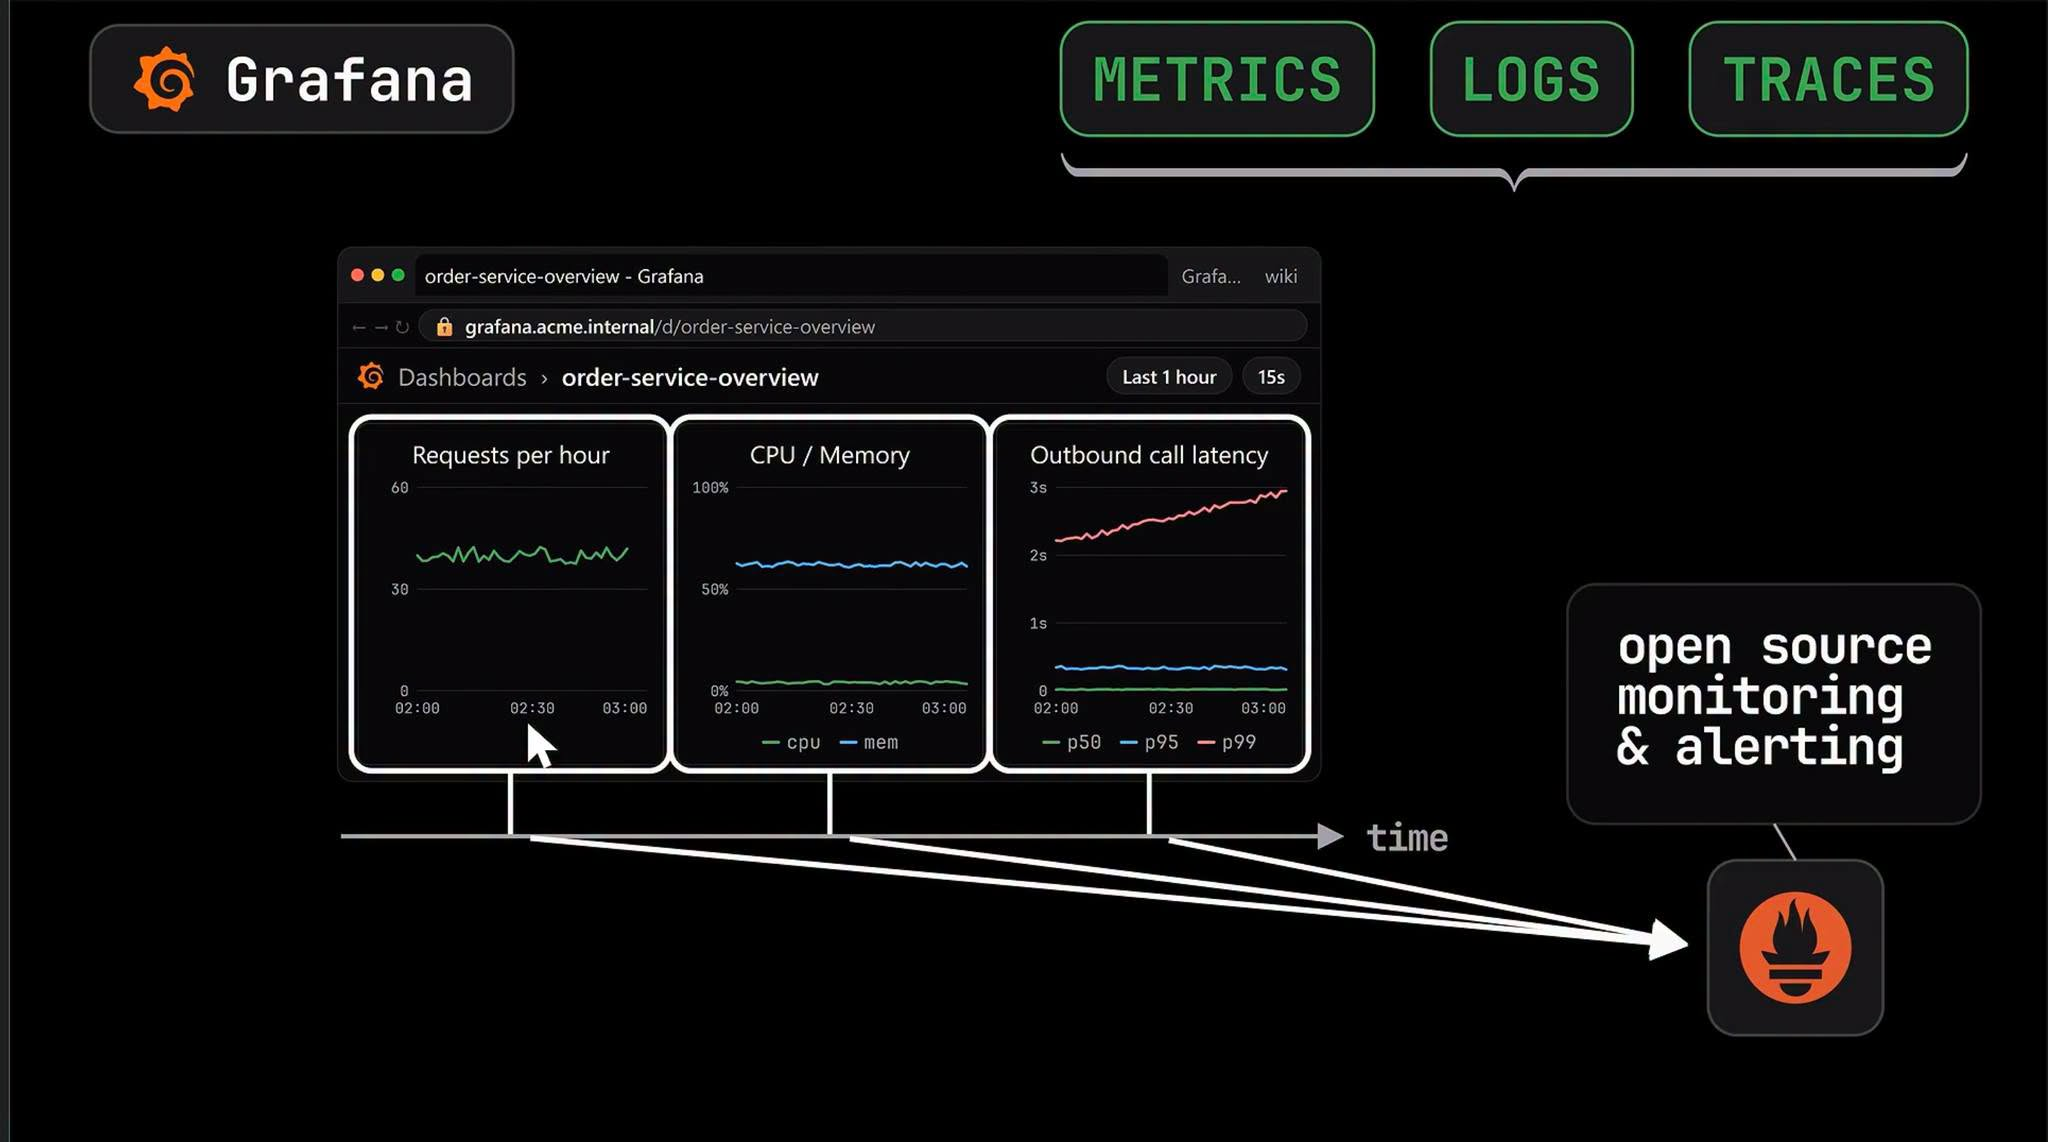
Lớp rào đầu tiên là kiểm tra Metrics trên Grafana (nền tảng trực quan hóa dữ liệu) với nguồn dữ liệu được scrape (thu thập tự động) định kỳ mỗi 15 giây từ các HTTP endpoint (điểm cuối giao tiếp HTTP) của từng service đưa về Time Series Database (cơ sở dữ liệu chuỗi thời gian) của Prometheus (bộ công cụ giám sát và cảnh báo mã nguồn mở). Khi mở dashboard (bảng điều khiển) của Order Service, có 3 loại metric cơ bản cần nhìn vào để loại trừ nguyên nhân:
 41c414d9-35ba-80c1-bd22-c651383d3411.png
 41c414d9-35ba-8088-a54f-f5c0a1ad8767.png
Đầu tiên là http_requests_total thuộc kiểu Counter (bộ đếm - chỉ số chỉ tăng dần theo thời gian). Biểu đồ tốc độ tăng trưởng cho thấy lưu lượng đi vào giữ nguyên ở mức phẳng khoảng 40 requests/giờ, tức là hệ thống hoàn toàn không bị DDoS (tấn công từ chối dịch vụ phân tán) hay spike traffic.
 41c414d9-35ba-80a9-9020-f4c450856f45.png
Tiếp theo là biểu đồ CPU và Memory (bộ nhớ) thuộc kiểu Gauge (đồng hồ đo - chỉ số có thể tăng giảm tùy thời điểm). CPU của Order Service lúc này chỉ loanh quanh mức 4% và RAM đi ngang, chứng tỏ bản thân con Order Service rất rảnh rỗi, không hề bị quá tải tài nguyên hay kẹt Garbage Collection (quá trình thu gom rác bộ nhớ).
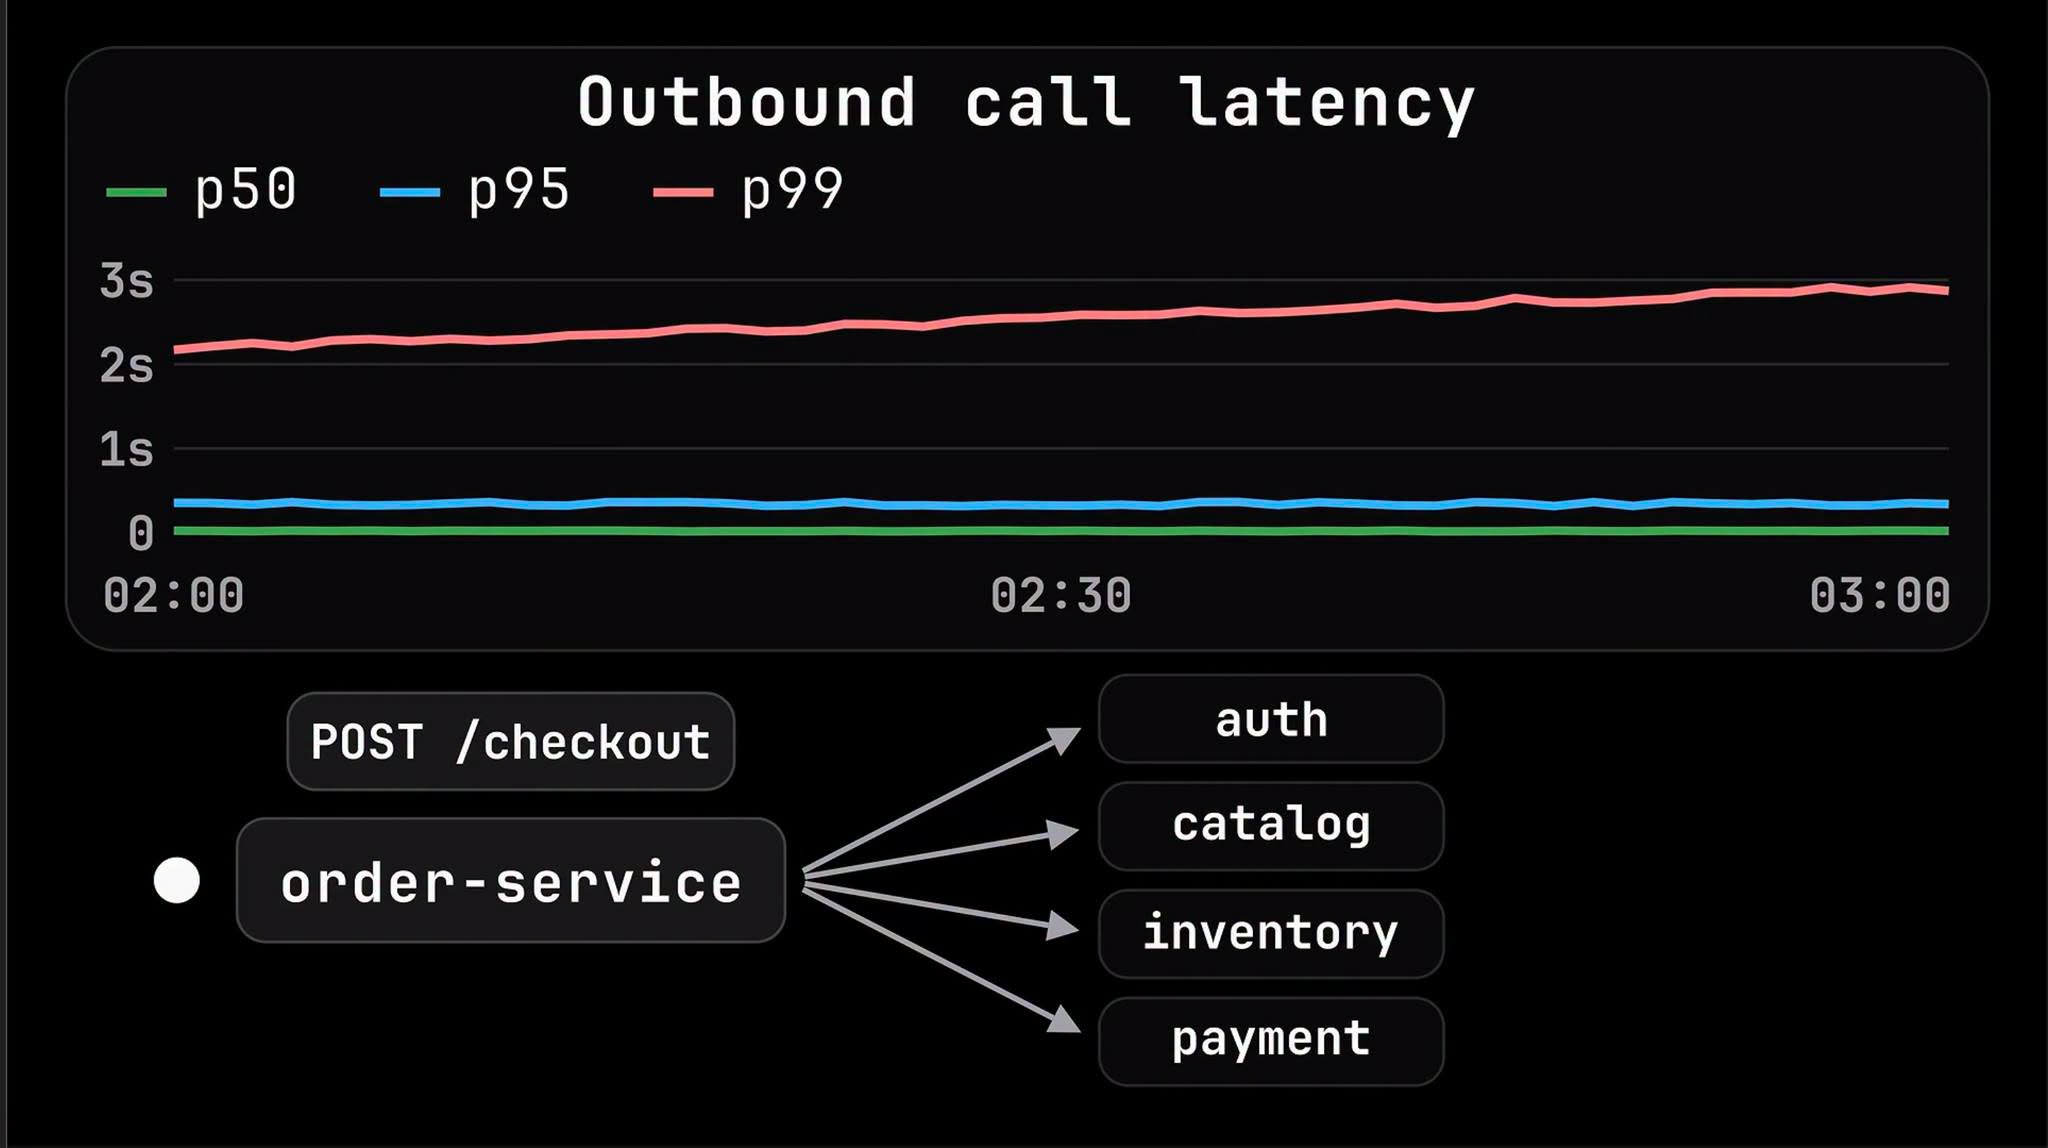
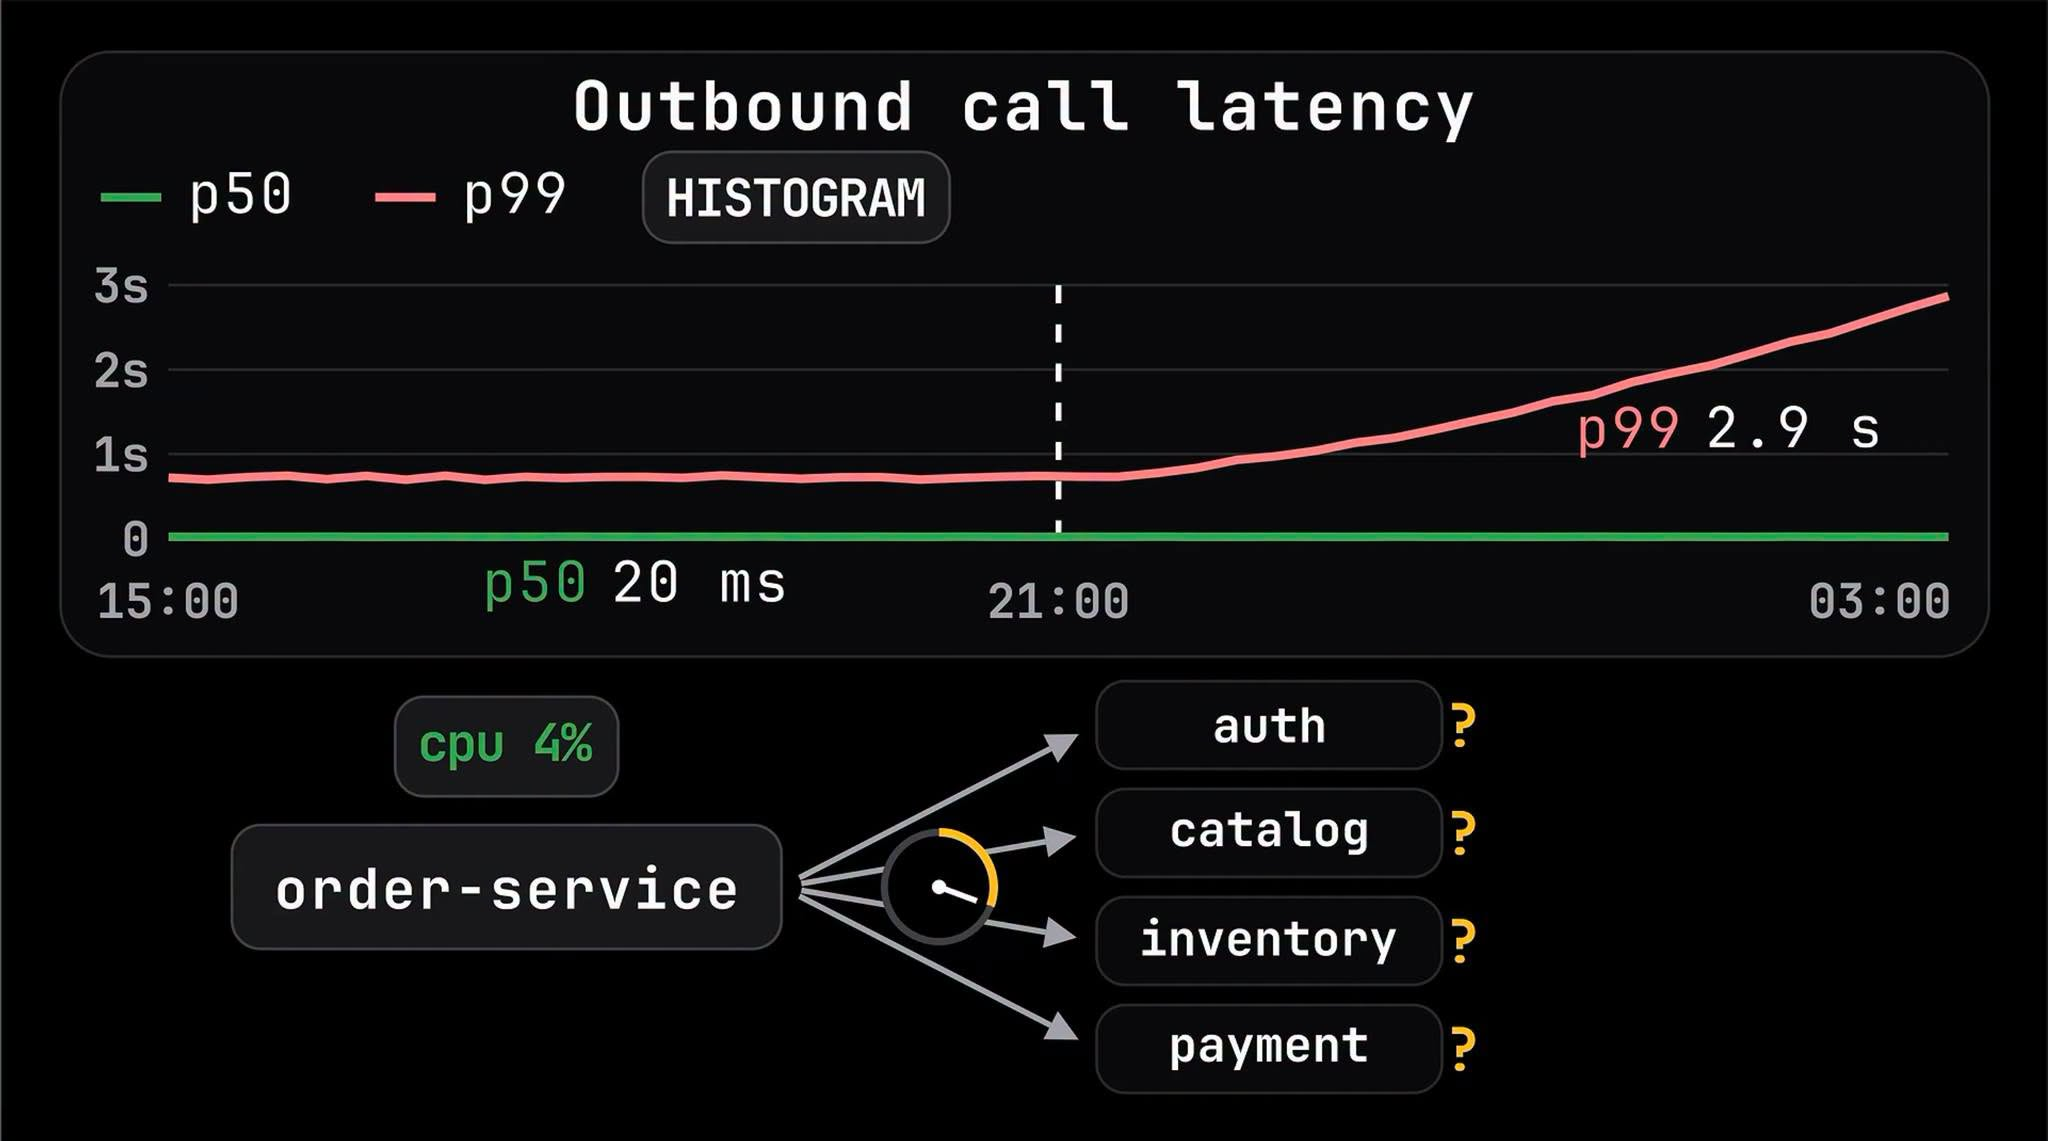
Manh mối thực sự nằm ở biểu đồ thứ ba: Outbound Call Latency (độ trễ của các cuộc gọi đi ra ngoài) từ Order Service được đo bằng kiểu Histogram (biểu đồ tần suất - phân bổ thời gian phản hồi vào các bucket/nhóm thời gian định sẵn như 0-10ms, 10-30ms, 30-100ms). Ở đây chỉ số P50 (phân vị thứ 50 hay trung vị - 50% request nhanh hơn mức này) vẫn giữ ở mức rất đẹp là 20ms. Tuy nhiên chỉ số P99 lại dựng đứng lên mức 2.9 giây và đã âm ỉ tăng từ 9 giờ tối. Điều này khẳng định Order Service hoàn toàn khỏe mạnh, nhưng trong quá trình xử lý nó phải gọi sang một loạt service khác như Inventory, Payment (thanh toán), Auth (xác thực) và đang bị một thằng nào đó giữ chân.
 41c414d9-35ba-80be-abe7-d6e93148727d.png
Tới đây thì Metrics hết nhiệm vụ vì bản chất của Metrics là các aggregated numbers (con số tổng hợp), nó không thể chỉ đích danh từng request đơn lẻ đang gọi sang service nào bị chậm. Để thu hẹp hàng rào thêm một nấc nữa, chúng ta phải chuyển sang Logs.
 41c414d9-35ba-8041-818e-fa687da80828.png
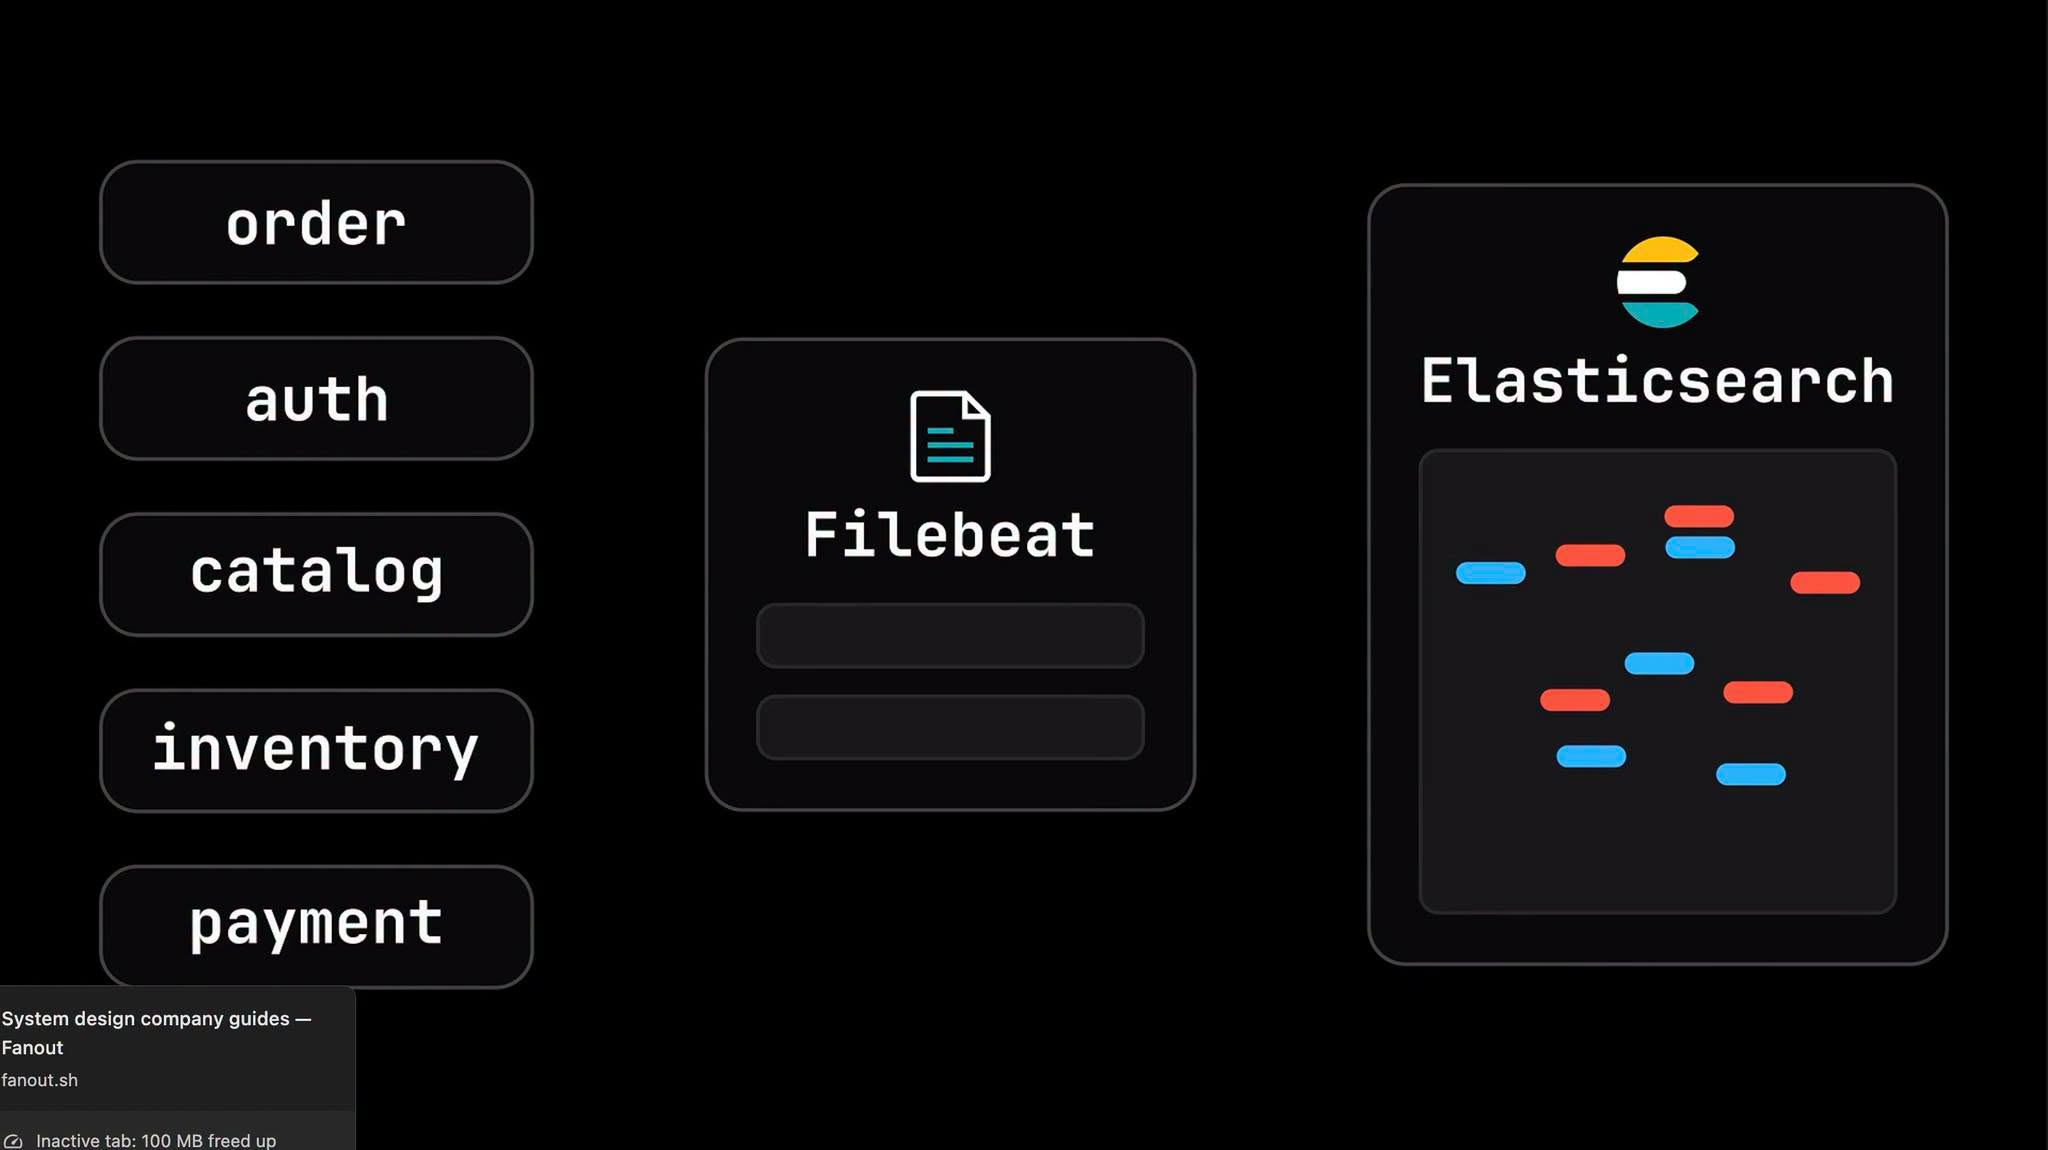
Các dòng log trong hệ thống được ghi ra kèm severity level (mức độ nghiêm trọng như INFO, WARN, ERROR) dưới định dạng JSON hay còn gọi là Structured Logging (ghi nhận nhật ký có cấu trúc) để dễ dàng lọc theo từng trường dữ liệu. Một log collector (bộ thu thập nhật ký) như Filebeat sẽ lắng nghe luồng stdout/stderr (đầu ra chuẩn và đầu ra lỗi chuẩn) của mọi service rồi đẩy về Elasticsearch (hệ quản trị cơ sở dữ liệu tìm kiếm và phân tích) để index (đánh chỉ mục). Từ giao diện Grafana, khi lọc trực tiếp vào datasource (nguồn dữ liệu) Elasticsearch với điều kiện: service = order-service, route = /checkout, và duration >= 2000ms, toàn bộ các request bị ngâm lâu đều lộ diện. Mở chi tiết một bản ghi mất 2,970ms ra xem thì thấy thủ phạm làm chậm chính là lời gọi outbound sang Inventory Service.
 41c414d9-35ba-808a-bde6-e621ed3df99b.png
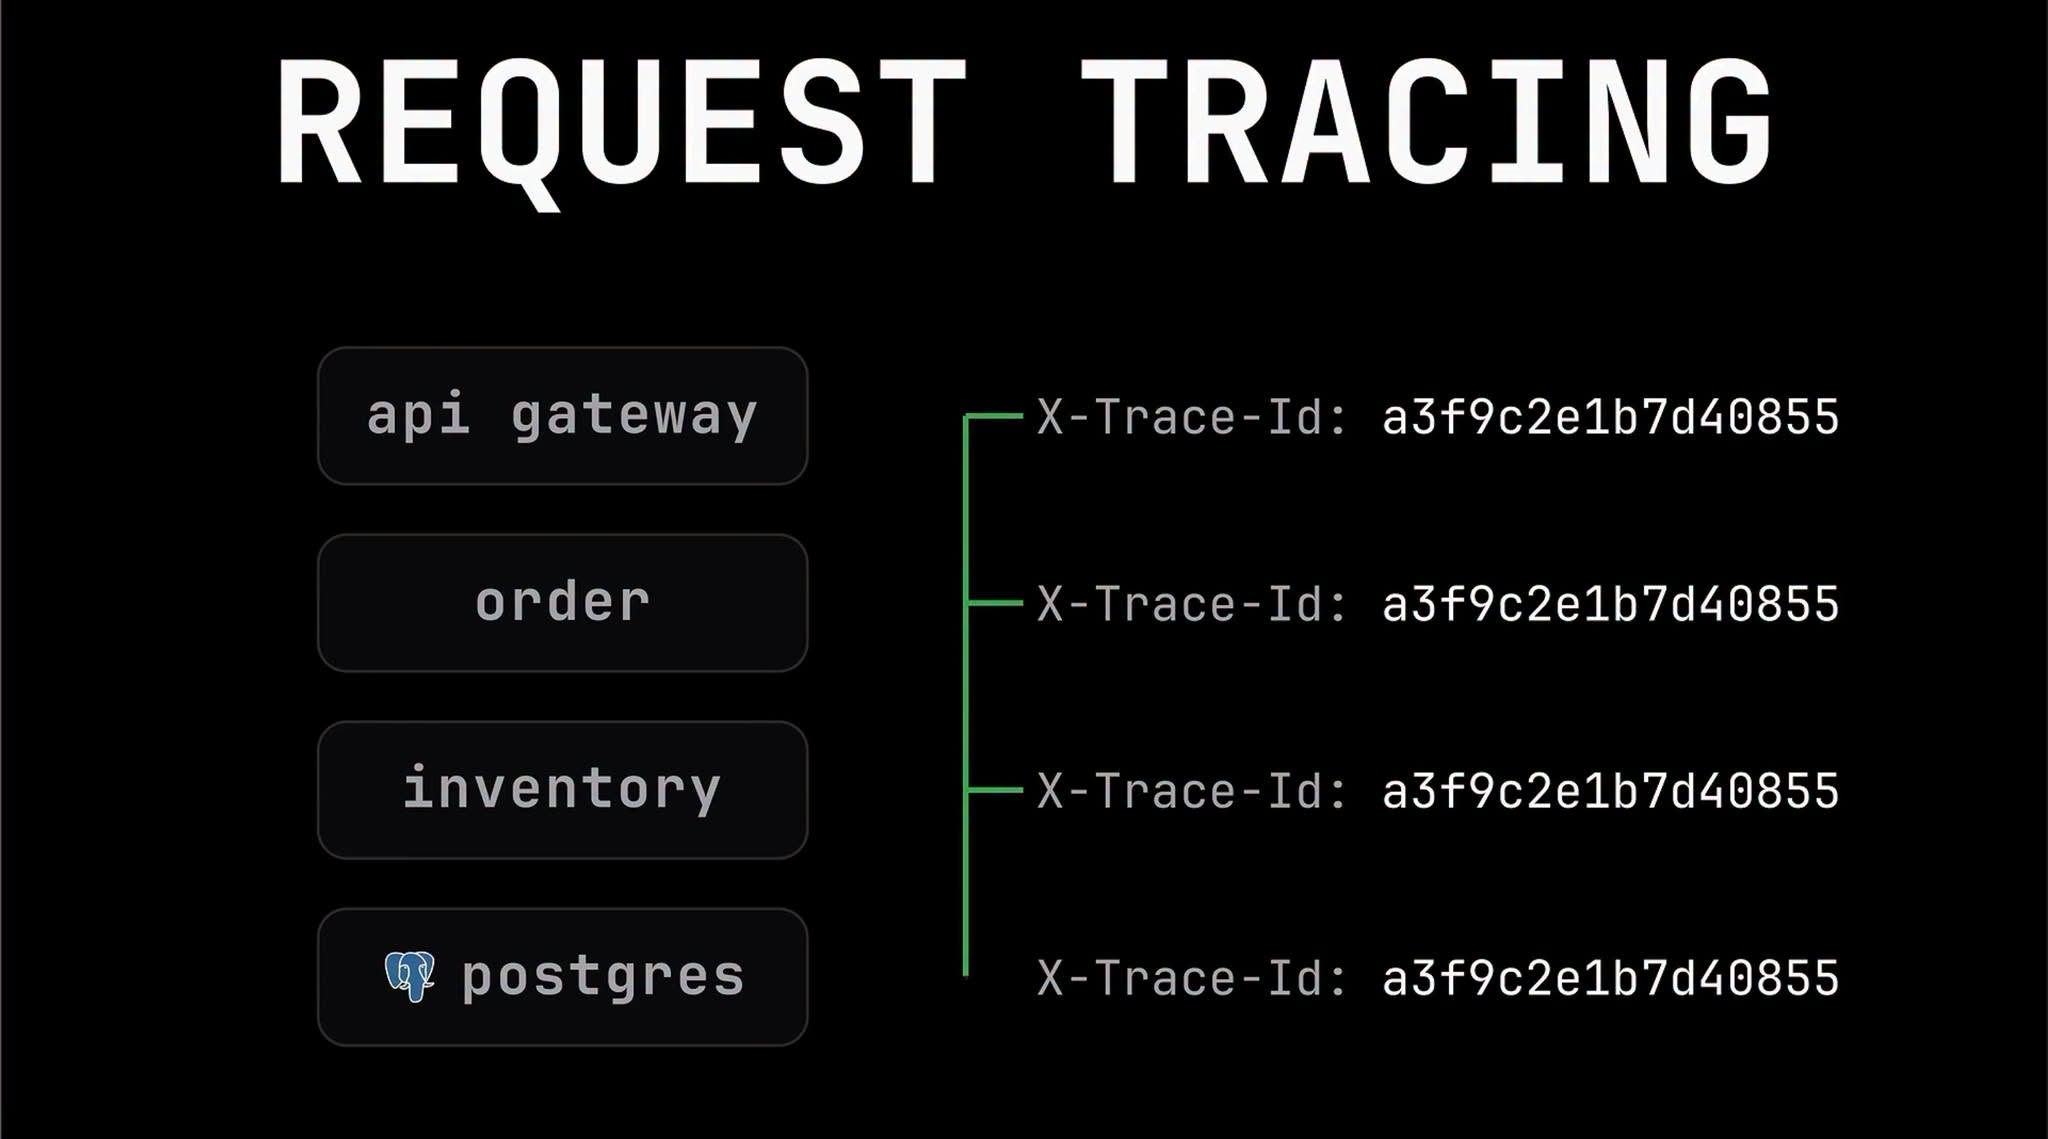
Thông thường bước tiếp theo là cầm Trace ID (mã định danh truy vết duy nhất được API Gateway sinh ra, gắn vào HTTP Header - phần đầu của gói tin HTTP - và truyền xuyên suốt qua các downstream services) để đem đi tìm log bên phía Inventory Service. Nhưng một tình huống rất đời thực xảy ra: tìm Trace ID đó trong log của Inventory Service thì trắng trơn không có một dòng nào, đơn giản vì lúc viết code cho service này lập trình viên đã quên không cấu hình đẩy Trace ID vào log context (ngữ cảnh nhật ký, chẳng hạn như MDC - Mapped Diagnostic Context trong Java/SLF4J).
 41c414d9-35ba-80c0-a4c1-ea174921bb87.png
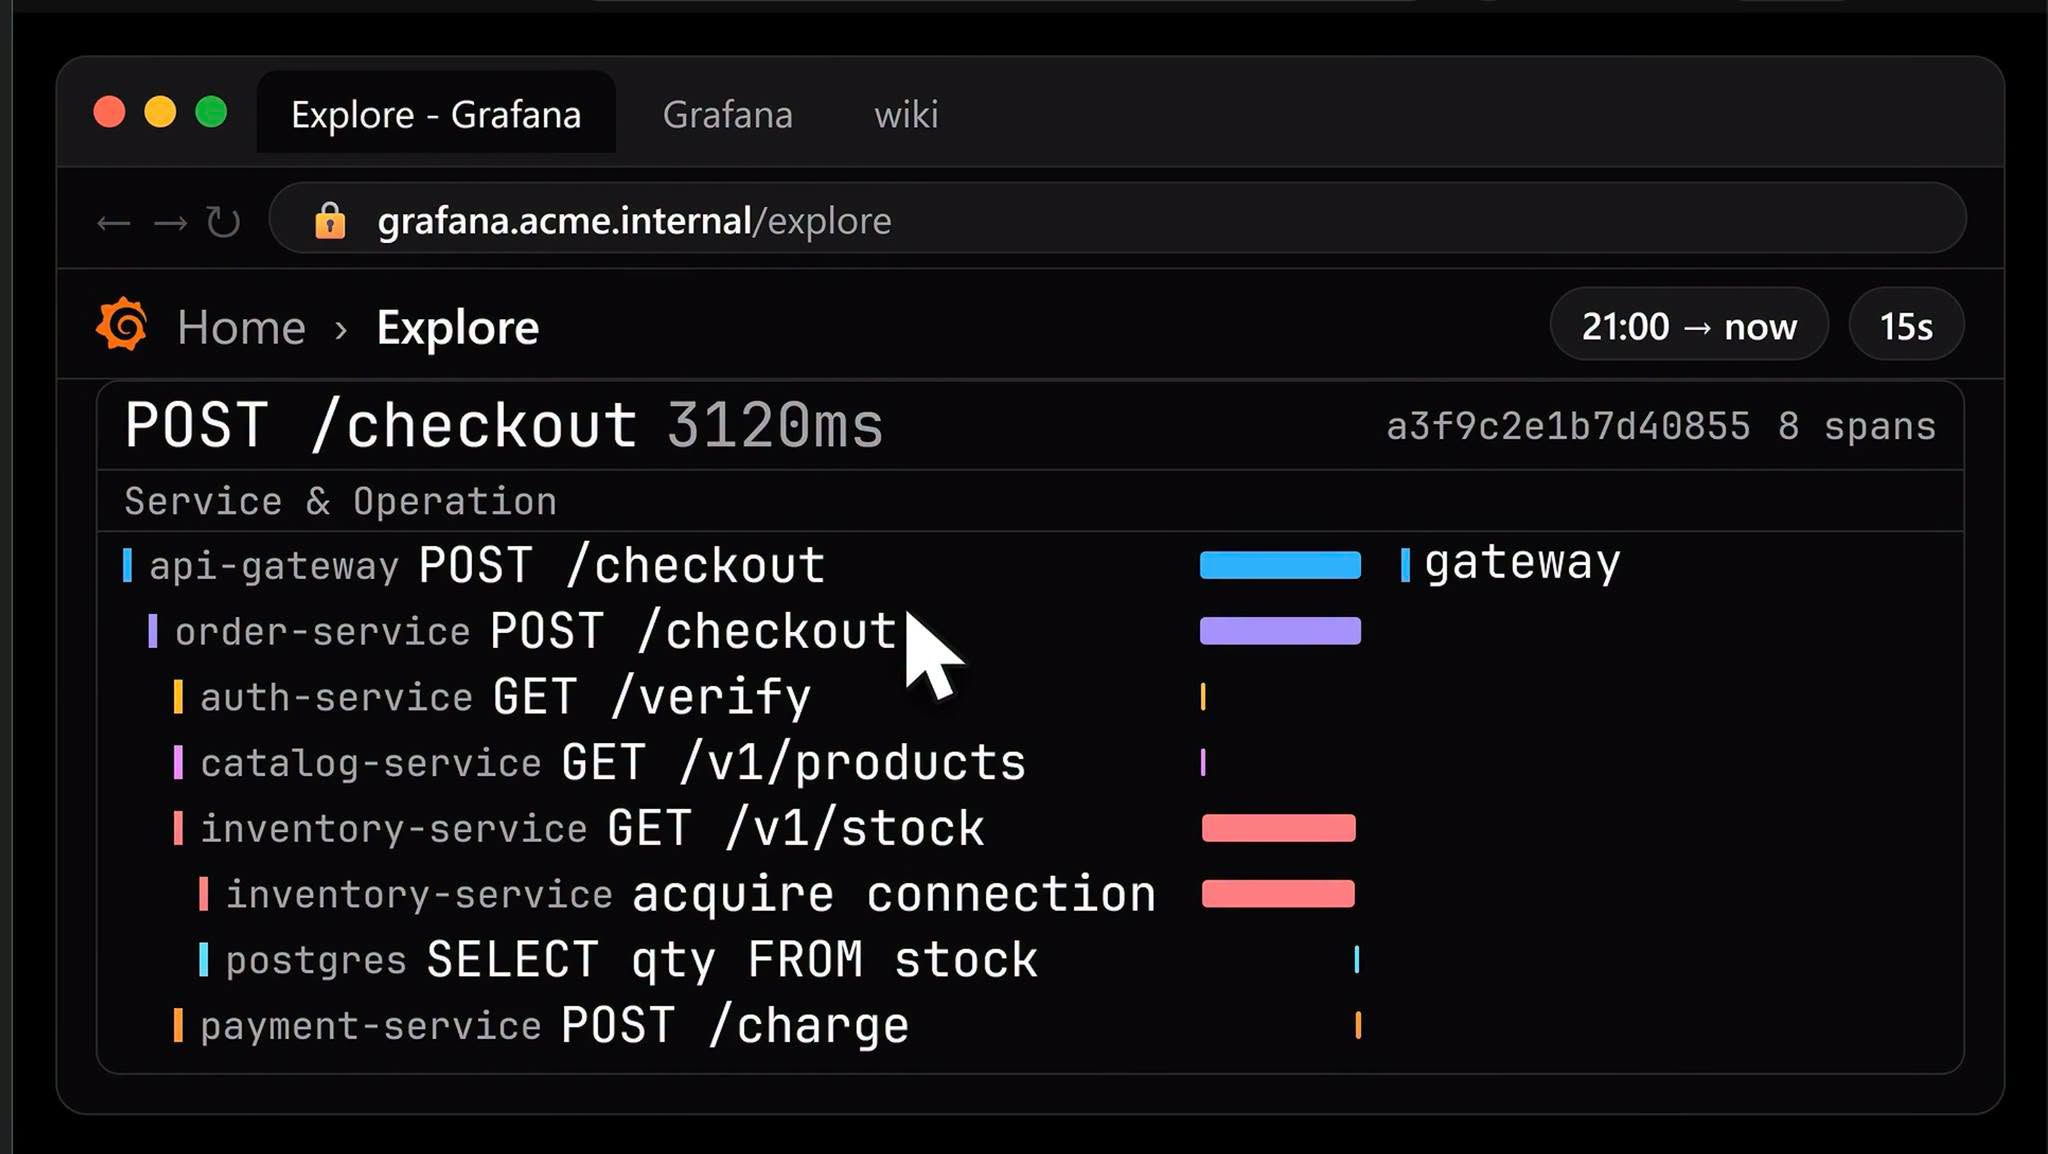
Khi log bị đứt đoạn, công cụ cuối cùng để lật tẩy vấn đề là Distributed Tracing. Đem đúng cái Trace ID đó tra cứu trên công cụ Tracing, toàn bộ lifecycle (vòng đời) của request hiện ra dưới dạng biểu đồ timeline (dòng thời gian) gồm các Span (nhịp thực thi - mỗi Span đại diện cho một đơn vị công việc cụ thể trong một service). Nhìn vào timeline của request mất 3,120ms này, bức tranh hiện ra cực kỳ rõ ràng:
- Request đi qua API Gateway rồi proxy (chuyển tiếp) vào Order Service.
- Order Service gọi sang Auth Service để xác thực người dùng chỉ mất vỏn vẹn 8ms.
- Order Service gọi tiếp sang Inventory Service và bị ngâm ở đây tới 2,970ms.
Điểm ăn tiền nhất của Tracing là khi bung chi tiết các Span con bên trong Inventory Service ra: câu lệnh chạy SQL Query (truy vấn cơ sở dữ liệu) thực chất chỉ tốn đúng 4ms, nhưng cái Span ngay trước đó là acquire connection (xin cấp kết nối tới cơ sở dữ liệu) lại ngốn tới 2,962ms.
 41c414d9-35ba-807d-b38a-cd971f9f351e.png
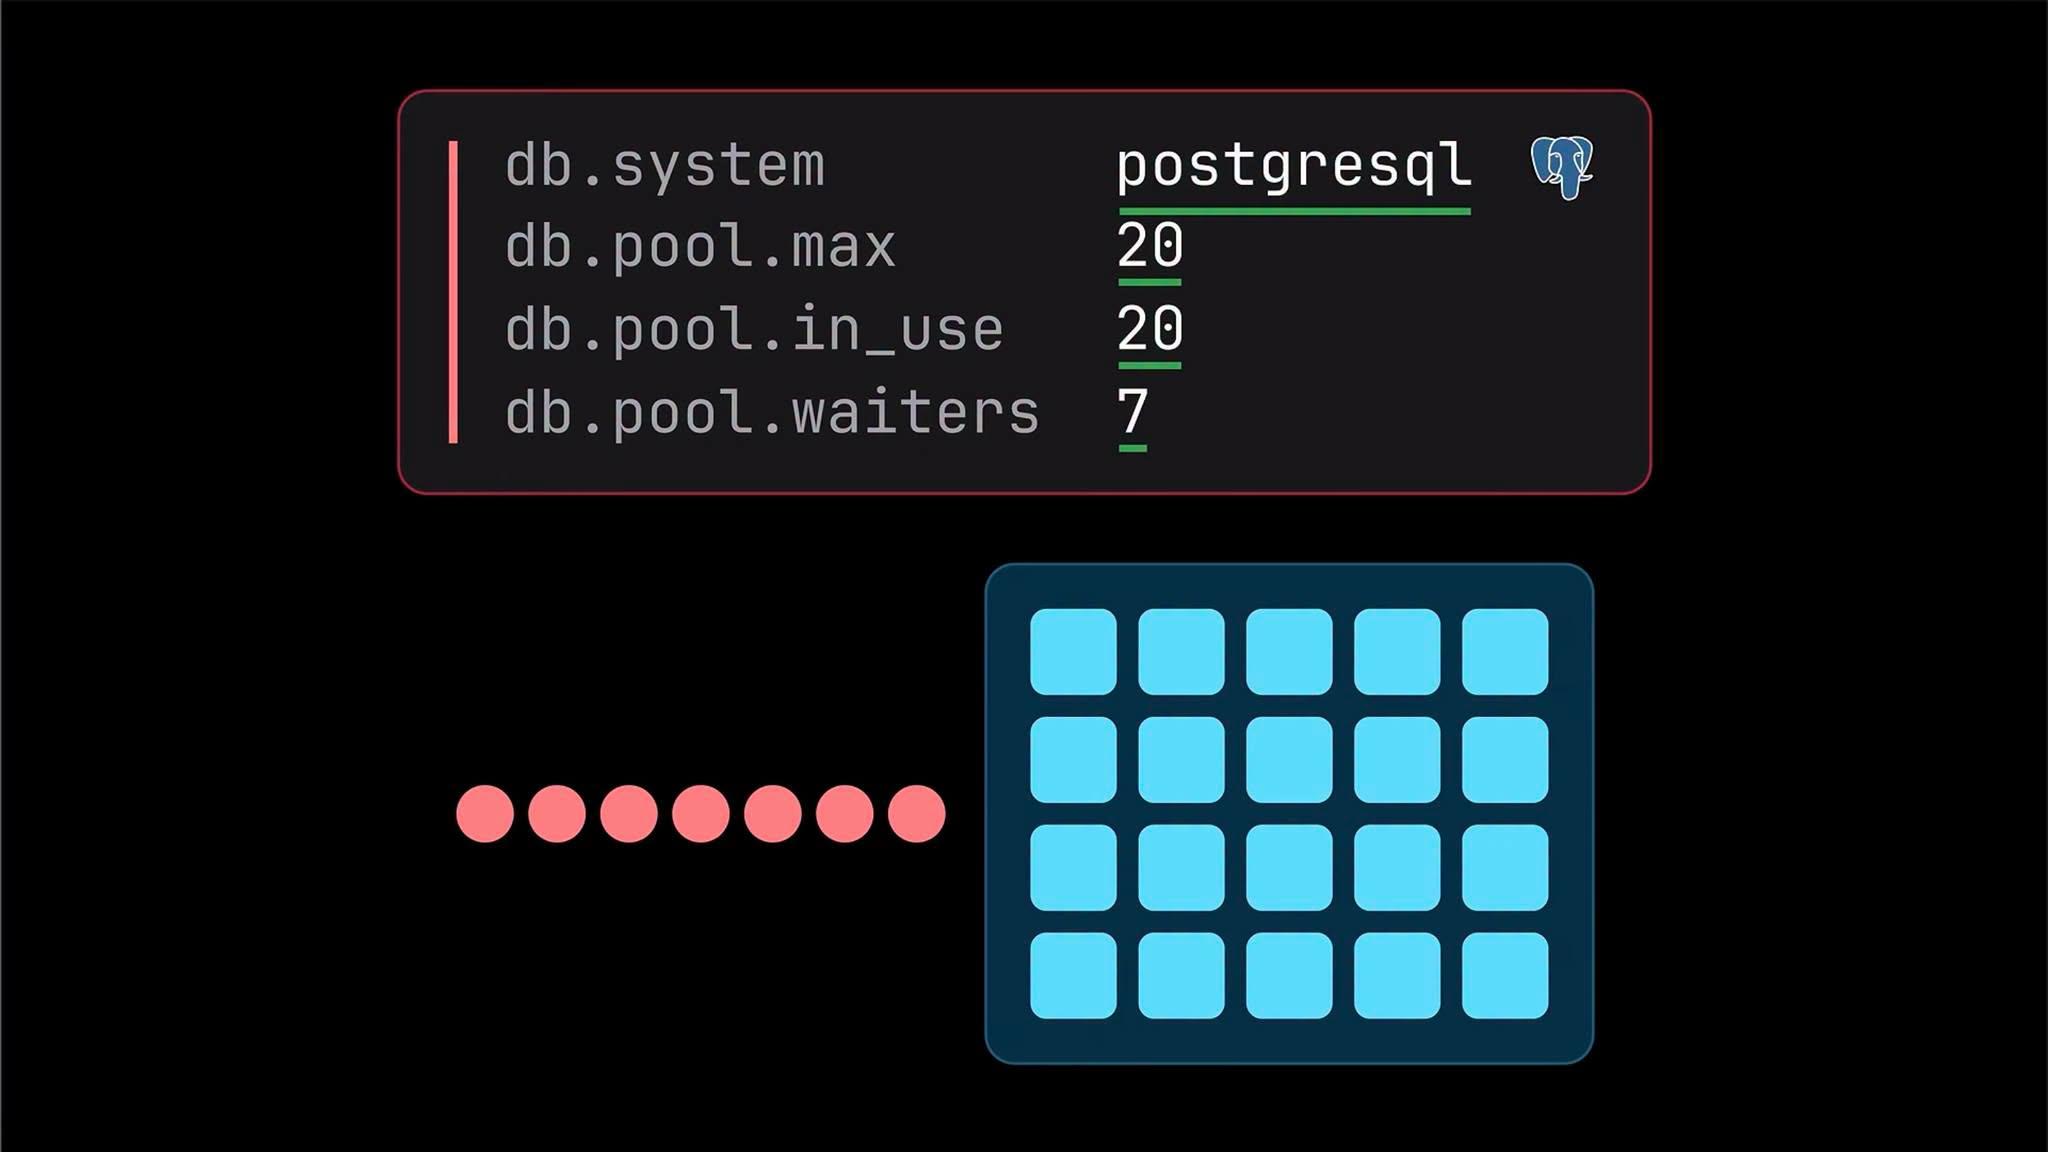
Khi kiểm tra phần Span Attributes (các thuộc tính ngữ cảnh của nhịp thực thi) ở bước xin cấp kết nối này thì nguyên nhân gốc rễ lộ diện: ứng dụng đang dùng một Connection Pool kết nối tới PostgreSQL với cấu hình max_pool_size = 20 (kích thước vùng chứa tối đa là 20 kết nối). Ngay tại thời điểm đó, cả 20 connections đều đang ở trạng thái in_use (đang được sử dụng 100%) và có tới 7 requests khác đang phải xếp hàng chờ được nhả connection ra.
 41c414d9-35ba-8022-8d05-df56b42a9b82.png
Đây chính là lỗi kinh điển Connection Pool Exhaustion xuất phát từ việc bị Connection Leak. Trong quá trình viết code tương tác với Database, có một luồng xử lý nào đó đã mượn connection từ Pool ra nhưng khi chạy xong hoặc khi văng Exception (ngoại lệ/lỗi thực thi) lại quên không gọi lệnh close() (đóng) để trả connection đó về lại cho Pool. Cứ mỗi lần đi vào nhánh code lỗi đó, Pool lại mất vĩnh viễn một connection cho tới khi chạm trần 20 kết nối, khiến các request đến sau phải đứng đợi tới lúc bị timeout (hết thời gian chờ).
Phần kết của video khá hài hước nhưng cũng rất thực tế: vì con Inventory Service này do một người đã nghỉ việc từ hơn một năm trước viết ra và không ai dám sửa code lúc 3 giờ sáng, giải pháp workaround (chữa cháy tạm thời) của team trực on-call (trực sự cố) là... restart (khởi động lại) lại pod/service để xóa sạch Connection Pool làm lại từ đầu. Tất nhiên về mặt kỹ thuật, để trị dứt điểm tận gốc trong code (đặc biệt với anh chị em làm Java/Spring Boot với thư viện quản lý kết nối HikariCP), chúng ta bắt buộc phải rà soát lại các chỗ mở connection thủ công để đưa vào khối try-with-resources (cấu trúc tự động đóng tài nguyên), quản lý chặt vòng đời của @Transactional (quản lý giao dịch cơ sở dữ liệu), đồng thời bật thêm các cấu hình như leakDetectionThreshold (ngưỡng thời gian phát hiện rò rỉ kết nối) để hệ thống tự động in ra stack trace (dấu vết ngăn xếp lỗi) cảnh báo ngay khi có một connection bị giữ quá lâu.
Không biết trong dự án của mọi người hiện tại đã gắn đầy đủ bộ ba Metrics, Logs kèm Trace ID đồng bộ từ tầng Gateway xuống tận Database chưa, và anh chị em đã bao giờ phải dậy lúc 3 giờ sáng chỉ để restart service vì lỗi rò rỉ connection kiểu này chưa?