On this page
Khi backend tăng tải: Cách bóc tách và mở rộng hệ thống từ 1 đến 10 triệu users
Chủ đề “Scaling on AWS for the first 10 million users” (trước đây có tên “Scaling Up to Your First 10 Million Users”) là một trong những nội dung kiến trúc kinh điển tại AWS re:Invent, từng được trình bày trong 6 kỳ liên tiếp từ 2014 đến 2019, sau đó tiếp tục trở lại trong các kỳ 2022, 2023 và 2024.
Trong bài viết này, mình muốn giới thiệu lại video kỳ re:Invent 2019 (ARC211-R) của hai diễn giả Brian Farnhill và Hong Pham. Lý do mình chọn bản 2019 làm tài liệu tham khảo là vì cách tiếp cận dựa trên các thành phần hạ tầng quen thuộc giúp anh em kỹ sư backend rất dễ hình dung bức tranh tổng thể:
- EC2 instance: Virtual Machine (máy ảo) có thể dùng để chạy ứng dụng Java/Spring Boot.
- RDS: Managed relational database (cơ sở dữ liệu quan hệ được quản lý sẵn).
- ELB: Dịch vụ cân bằng tải (load balancing).
- ElastiCache: Cụm in-memory cache được quản lý sẵn (Redis / Memcached).
- S3: Object storage lưu trữ tệp tin.
- CloudFront: Mạng phân phối nội dung (CDN).
- SQS: Message queue phục vụ xếp hàng thông điệp.
Đây là sự ánh xạ về vai trò kiến trúc để anh em dễ đối chiếu khi thiết kế trên on-premises hoặc các nền tảng đám mây khác, không phải sự tương đương 1:1 về API hay bảo đảm vận hành. Nếu tự vận hành các thành phần này trên hạ tầng tự quản, đội ngũ kỹ thuật sẽ cần tự chịu trách nhiệm về sao lưu (backup), chuyển đổi dự phòng (failover), giám sát (monitoring) và quản lý năng lực (capacity planning).
Theo mình, các phiên bản 2022–2024 thiên nhiều hơn về các giải pháp managed chuyên sâu hoặc serverless của AWS (như AWS Amplify, AWS App Runner), nên người xem sẽ cần làm quen thêm tên dịch vụ để nắm bắt sơ đồ. Bản 2019 thể hiện rất rõ lộ trình tiến hóa từ máy ảo, cơ sở dữ liệu quan hệ đến cân bằng tải và hàng đợi (dù ở phần sau video cũng mở rộng sang container và serverless). Các mốc từ 1 đến 10 triệu người dùng trong bài giảng thực chất là lộ trình minh họa theo sự tăng trưởng của workload, không phải cam kết dung lượng cố định hay lượng người dùng đồng thời (concurrent users).
Dưới đây là các bước chuyển dịch kiến trúc quan trọng được đúc kết từ video.
1. Khởi đầu với kiến trúc phân tách cơ bản và ưu tiên SQL
Trong video, xuất phát điểm ngày đầu tiên của hệ thống đã là mô hình gồm instance ứng dụng riêng và instance cơ sở dữ liệu riêng biệt.
Diễn giả khuyến nghị cơ sở dữ liệu quan hệ (SQL) là điểm khởi đầu hợp lý cho phần lớn ứng dụng. Công nghệ SQL đã rất trưởng thành, hệ sinh thái công cụ dồi dào và các pattern mở rộng đã được kiểm chứng qua nhiều thập kỷ. Quyết định lựa chọn SQL hay NoSQL nên phụ thuộc vào access pattern và đặc thù mô hình dữ liệu thực tế của bài toán.
Khi ứng dụng bắt đầu có thêm người dùng, phương pháp mở rộng theo chiều dọc (vertical scaling hay scale up - nâng cấp CPU, RAM của máy chủ) mang lại lợi thế lớn nhất là sự đơn giản: hệ thống không cần thay đổi kiến trúc hay code xử lý. Tuy nhiên, scale up có giới hạn phần cứng và gặp hiện tượng hiệu suất biên giảm dần (diminishing returns). Ngoài ra, việc dồn tải vào một máy chủ duy nhất vẫn tiềm ẩn rủi ro điểm lỗi đơn lẻ (Single Point of Failure - SPOF).
2. Chuyển sang Managed Database và thiết lập dự phòng nội bộ (Multi-AZ)
Để giải phóng đội ngũ kỹ thuật khỏi các công việc vận hành bảo trì (vá lỗi hệ điều hành, sao lưu tự động), cơ sở dữ liệu được chuyển từ dạng tự quản trên máy ảo sang dịch vụ managed như Amazon RDS.
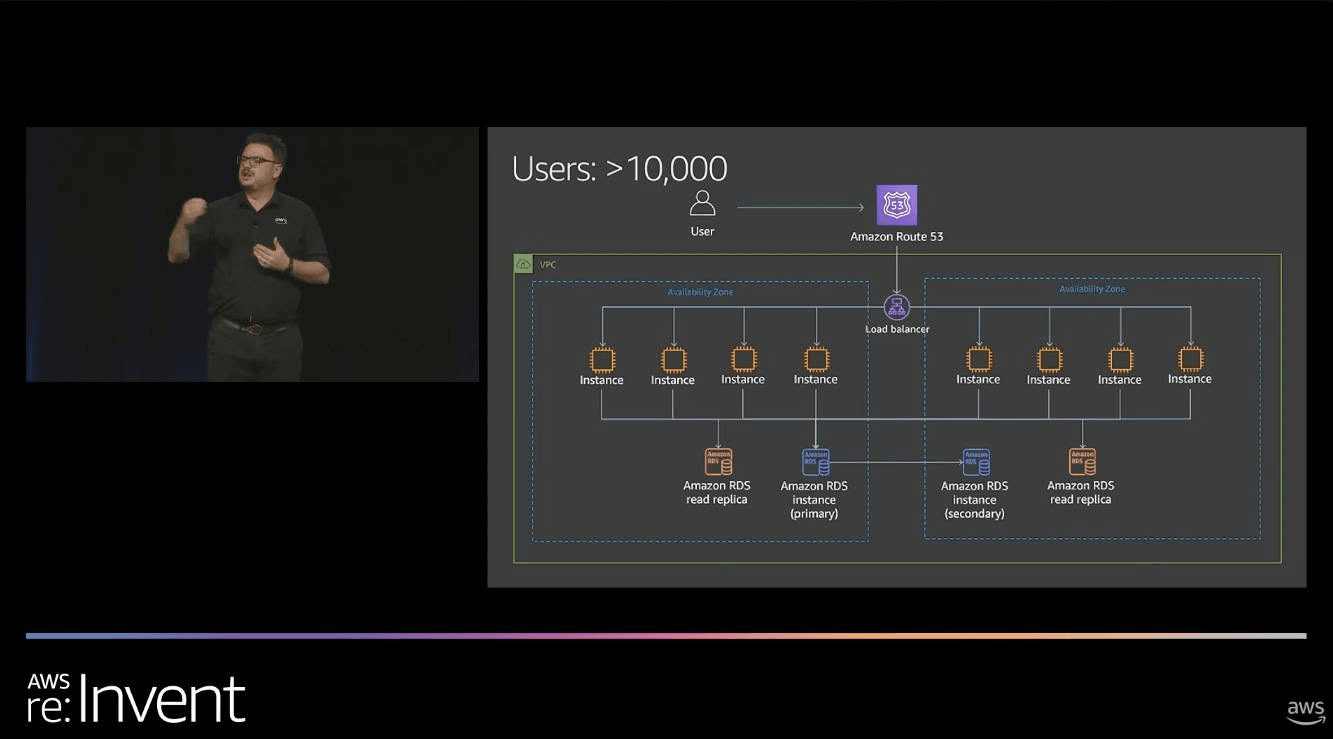
Để tăng tính sẵn sàng, cơ sở dữ liệu được cấu hình Multi-AZ, tức là triển khai trên nhiều Availability Zone (khu vực sẵn sàng độc lập về nguồn điện và mạng) trong cùng một Region. Trong mô hình RDS primary/standby được minh họa ở bài giảng:
Node chính (Primary) tiếp nhận toàn bộ tác vụ đọc và ghi từ ứng dụng.
- Node chính (Primary) tiếp nhận toàn bộ tác vụ đọc và ghi từ ứng dụng.
Node dự phòng (Standby) nhận dữ liệu sao chép đồng bộ từ node chính và chỉ kích hoạt khi xảy ra sự cố chuyển đổi dự phòng (failover nội bộ trong Region), hoàn toàn không phục vụ mục đích san sẻ tải đọc.
- Node dự phòng (Standby) nhận dữ liệu sao chép đồng bộ từ node chính và chỉ kích hoạt khi xảy ra sự cố chuyển đổi dự phòng (failover nội bộ trong Region), hoàn toàn không phục vụ mục đích san sẻ tải đọc.
3. Mở rộng tầng tính toán với Load Balancing và ứng dụng stateless
Khi lưu lượng truy cập vượt quá khả năng xử lý của một instance ứng dụng, giải pháp là mở rộng theo chiều ngang (horizontal scaling hay scale out): bổ sung thêm các máy chủ backend chạy song song phía sau hệ thống cân bằng tải (ELB).
Với ứng dụng Java, anh em có thể liên hệ:
Muốn scale ngang hiệu quả, backend cần giảm tối đa việc phụ thuộc vào trạng thái lưu cục bộ trong bộ nhớ (local state) để bất kỳ instance nào cũng có thể xử lý request gửi tới.
- Muốn scale ngang hiệu quả, backend cần giảm tối đa việc phụ thuộc vào trạng thái lưu cục bộ trong bộ nhớ (local state) để bất kỳ instance nào cũng có thể xử lý request gửi tới.
Nếu ứng dụng có sử dụng server-side session, đội ngũ phát triển có thể cân nhắc chuyển session state ra một kho lưu trữ dùng chung bên ngoài (chẳng hạn như cụm Redis) thay vì ghim chặt session vào heap của một JVM cụ thể.
- Nếu ứng dụng có sử dụng server-side session, đội ngũ phát triển có thể cân nhắc chuyển session state ra một kho lưu trữ dùng chung bên ngoài (chẳng hạn như cụm Redis) thay vì ghim chặt session vào heap của một JVM cụ thể.
4. Giảm tải cho Web Tier và Database: Tách tài nguyên tĩnh, Read Replicas và Caching
Khi hệ thống tiếp tục tăng trưởng, việc tiếp tục bổ sung máy chủ backend sẽ kém hiệu quả nếu không tìm cách bóc tách các loại tải khác nhau:
Đưa tài nguyên tĩnh ra ngoài: Tệp tĩnh (JS, CSS, hình ảnh) được chuyển sang Object Storage (S3) và phân phối qua CDN (CloudFront) đặt tại các điểm biên gần người dùng. Việc này giúp máy chủ backend Java giải phóng băng thông và CPU để tập trung hơn vào business logic và dynamic content.
- Đưa tài nguyên tĩnh ra ngoài: Tệp tĩnh (JS, CSS, hình ảnh) được chuyển sang Object Storage (S3) và phân phối qua CDN (CloudFront) đặt tại các điểm biên gần người dùng. Việc này giúp máy chủ backend Java giải phóng băng thông và CPU để tập trung hơn vào business logic và dynamic content.
Phân tách tải đọc database (Read Replicas): Bổ sung các bản sao chỉ đọc. Các truy vấn đọc thông thường được điều hướng sang replica, giúp node Primary giữ tài nguyên cho các transaction ghi. Các truy vấn đòi hỏi dữ liệu mới nhất vẫn cần đọc trực tiếp từ Primary. Khi sử dụng replica, hệ thống phải chấp nhận bài toán trễ sao chép bất đồng bộ (replication lag).
- Phân tách tải đọc database (Read Replicas): Bổ sung các bản sao chỉ đọc. Các truy vấn đọc thông thường được điều hướng sang replica, giúp node Primary giữ tài nguyên cho các transaction ghi. Các truy vấn đòi hỏi dữ liệu mới nhất vẫn cần đọc trực tiếp từ Primary. Khi sử dụng replica, hệ thống phải chấp nhận bài toán trễ sao chép bất đồng bộ (replication lag).
Bộ nhớ đệm trong bộ nhớ (In-memory Cache): Đặt cụm cache (Redis/Memcached qua ElastiCache) phía trước database để phản hồi nhanh các truy vấn đọc lặp lại. Khi đưa cache vào production, kỹ sư cần tự tính toán kỹ thời gian sống của dữ liệu (TTL), cơ chế làm mới hoặc vô hiệu hóa cache (cache invalidation) và mức độ chấp nhận dữ liệu cũ (data freshness).
- Bộ nhớ đệm trong bộ nhớ (In-memory Cache): Đặt cụm cache (Redis/Memcached qua ElastiCache) phía trước database để phản hồi nhanh các truy vấn đọc lặp lại. Khi đưa cache vào production, kỹ sư cần tự tính toán kỹ thời gian sống của dữ liệu (TTL), cơ chế làm mới hoặc vô hiệu hóa cache (cache invalidation) và mức độ chấp nhận dữ liệu cũ (data freshness).
5. Tự động hóa, quan sát hệ thống và Auto Scaling
Việc đo lường và quan sát (telemetry) không phải là công việc chờ đến khi hệ thống lớn mới làm, mà cần thực hiện xuyên suốt qua vòng lặp Build -> Measure -> Learn. Đội ngũ kỹ thuật cần thu thập cả chỉ số hạ tầng (CPU, RAM) lẫn chỉ số ứng dụng (độ trễ, tỷ lệ lỗi), log tập trung và distributed tracing. Khi theo dõi tải CPU giữa các instance, việc phân tích theo phân vị (percentile như p90) giúp phát hiện sự mất cân bằng tải thay vì chỉ nhìn vào giá trị trung bình.
Lưu lượng người dùng thực tế luôn có chu kỳ biến động (ngày/đêm hoặc các đợt cao điểm đột xuất). Việc cấp phát dung lượng phần cứng cố định theo mức đỉnh cao nhất sẽ gây dư thừa rất nhiều tài nguyên trong các khung giờ thấp điểm. Khi tầng ứng dụng đã stateless và được giám sát đầy đủ, tính năng Auto Scaling sẽ tự động tăng hoặc giảm số lượng máy chủ theo nhu cầu tải thực tế.
Song song đó, việc ứng dụng Infrastructure as Code (IaC) và thiết lập pipeline triển khai tự động (CI/CD) sẽ giúp việc nhân bản môi trường, vá lỗi và release code diễn ra nhất quán, hạn chế thao tác thủ công.
6. Kết nối lỏng (Loose Coupling) với Message Queue và kiến trúc hướng dịch vụ
Khi nghiệp vụ ngày càng phức tạp, khối monolith có thể được bóc tách dần theo kiến trúc hướng dịch vụ (SOA) hoặc chia nhỏ thành các microservice, đóng gói trong container hoặc serverless function để triển khai và scale độc lập.
Để các dịch vụ không bị phụ thuộc chặt chẽ vào nhau, nguyên lý kết nối lỏng (Loose Coupling) được áp dụng thông qua Message Queue (SQS) hoặc Pub/Sub (SNS) cho các tác vụ có thể xử lý nền (ví dụ điển hình: gửi email thông báo, tạo file báo cáo):
Sau khi đưa message vào queue thành công, backend có thể phản hồi ngay cho client rằng yêu cầu đã được tiếp nhận, thay vì bắt người dùng chờ hoàn tất toàn bộ quy trình nghiệp vụ dài.
- Sau khi đưa message vào queue thành công, backend có thể phản hồi ngay cho client rằng yêu cầu đã được tiếp nhận, thay vì bắt người dùng chờ hoàn tất toàn bộ quy trình nghiệp vụ dài.
Hàng đợi đóng vai trò hấp thụ các đợt tăng đột biến lưu lượng (load leveling), giúp worker xử lý dần theo năng lực và scale độc lập với tầng web.
- Hàng đợi đóng vai trò hấp thụ các đợt tăng đột biến lưu lượng (load leveling), giúp worker xử lý dần theo năng lực và scale độc lập với tầng web.
Tuy nhiên, xử lý bất đồng bộ đòi hỏi lập trình viên phải giải quyết tốt bài toán thử lại (retry), thiết kế thao tác idempotent để việc xử lý lại cùng một message không lặp tác động nghiệp vụ, theo dõi backlog và đưa message xử lý lỗi kéo dài vào dead-letter queue khi phù hợp.
7. Khi database trở thành nút thắt
Ngay cả khi đã tối ưu tầng đọc bằng cache và read replicas, đến một mức tải nhất định, năng lực ghi của cụm cơ sở dữ liệu quan hệ vẫn có thể chạm ngưỡng giới hạn. Các hướng tiếp cận phổ biến gồm:
Database Federation: Tách cơ sở dữ liệu theo chức năng nghiệp vụ (ví dụ: database riêng cho Users, database riêng cho Products). Cách này san sẻ tải phần cứng hiệu quả nhưng khiến các câu lệnh join xuyên database và việc đảm bảo transaction liên domain trở nên phức tạp hơn ở tầng ứng dụng. Mỗi database sau khi tách vẫn có thể trở thành nút thắt riêng.
- Database Federation: Tách cơ sở dữ liệu theo chức năng nghiệp vụ (ví dụ: database riêng cho Users, database riêng cho Products). Cách này san sẻ tải phần cứng hiệu quả nhưng khiến các câu lệnh join xuyên database và việc đảm bảo transaction liên domain trở nên phức tạp hơn ở tầng ứng dụng. Mỗi database sau khi tách vẫn có thể trở thành nút thắt riêng.
Database Sharding: Giữ nguyên schema nhưng phân mảnh dữ liệu của cùng một bảng ra nhiều database server độc lập dựa trên Shard Key. Sharding mở rộng được năng lực ghi, nhưng đẩy gánh nặng rất lớn lên tầng ứng dụng trong việc định tuyến truy vấn, bảo trì schema đồng bộ và tái phân mảnh (rebalancing).
- Database Sharding: Giữ nguyên schema nhưng phân mảnh dữ liệu của cùng một bảng ra nhiều database server độc lập dựa trên Shard Key. Sharding mở rộng được năng lực ghi, nhưng đẩy gánh nặng rất lớn lên tầng ứng dụng trong việc định tuyến truy vấn, bảo trì schema đồng bộ và tái phân mảnh (rebalancing).
Chuyển một phần dữ liệu sang NoSQL: Đưa những tập dữ liệu phù hợp, chẳng hạn metadata hoặc dữ liệu phi quan hệ, sang NoSQL như DynamoDB để mở rộng độc lập với SQL. Quyết định dựa trên mô hình dữ liệu và access pattern.
- Chuyển một phần dữ liệu sang NoSQL: Đưa những tập dữ liệu phù hợp, chẳng hạn metadata hoặc dữ liệu phi quan hệ, sang NoSQL như DynamoDB để mở rộng độc lập với SQL. Quyết định dựa trên mô hình dữ liệu và access pattern.
Mở rộng hệ thống là quá trình đo lường nút thắt thực tế để tối ưu từng điểm nghẽn, không phải là việc áp dụng máy móc mọi công nghệ cùng lúc. Giữ hệ thống đơn giản nhất có thể ở giai đoạn đầu, duy trì khả năng thay đổi linh hoạt và chỉ bóc tách sâu hơn khi các chỉ số đo lường thực tế đòi hỏi.
Anh em trong quá trình vận hành hệ thống Java thực tế đã gặp tình huống nút thắt đầu tiên xuất hiện ở đâu: cạn thread pool/memory ở web tier, nghẽn I/O tại database ghi, hay vỡ tính nhất quán do cache invalidation? Cùng chia sẻ kinh nghiệm xử lý bên dưới nhé!
#VietnamJavaUserGroup #VietnamJUG #Java #JavaCommunity #SoftwareArchitecture #SystemDesign #Scalability #BackendEngineering #CloudArchitecture