Một Server 16 Cores chịu tải được bao nhiêu trong 1.000.000 Users?
Một Server 16 Cores chịu tải được bao nhiêu trong 1.000.000 Users? Cuộc chiến thực tế giữa C#, Java (Spring Boot), Go, Rust, Node.js và Python
by DuyNCT
3 weeks ago
On this page
TL;DR
- Bài test thực tế trên một Virtual Machine (16 vCPUs, 32GB RAM) chạy ứng dụng Social Media API để tìm giới hạn chịu tải hướng tới con số 1 triệu concurrent users (tương đương ~42.000 requests/s).
- Ở cấu hình mặc định chạy chung với SQLite trên 1 máy, không một ngôn ngữ nào chạm mốc 1 triệu users: C# dẫn đầu (722k), theo sau là Node.js (665k), Java Spring Boot (550k), Rust (535k), Python (420k) và bất ngờ nhất là Go đứng cuối (198k).
- Khi tách Database sang một máy chạy PostgreSQL riêng biệt, hiệu năng ban đầu thậm chí còn giảm do overhead từ network, connection management và driver.
- Điểm nghẽn thực sự không nằm ở bản thân ngôn ngữ, mà nằm ở Memory Pressure, Garbage Collection (GC), Gzip Middleware và Connection Pool.
Mọi người làm Backend hay System Design chắc hẳn đều từng nghe câu hỏi kinh điển: "Một con server đơn lẻ thực sự gánh được bao nhiêu user trước khi chúng ta phải nghĩ đến chuyện scale-out hay đổi kiến trúc?"
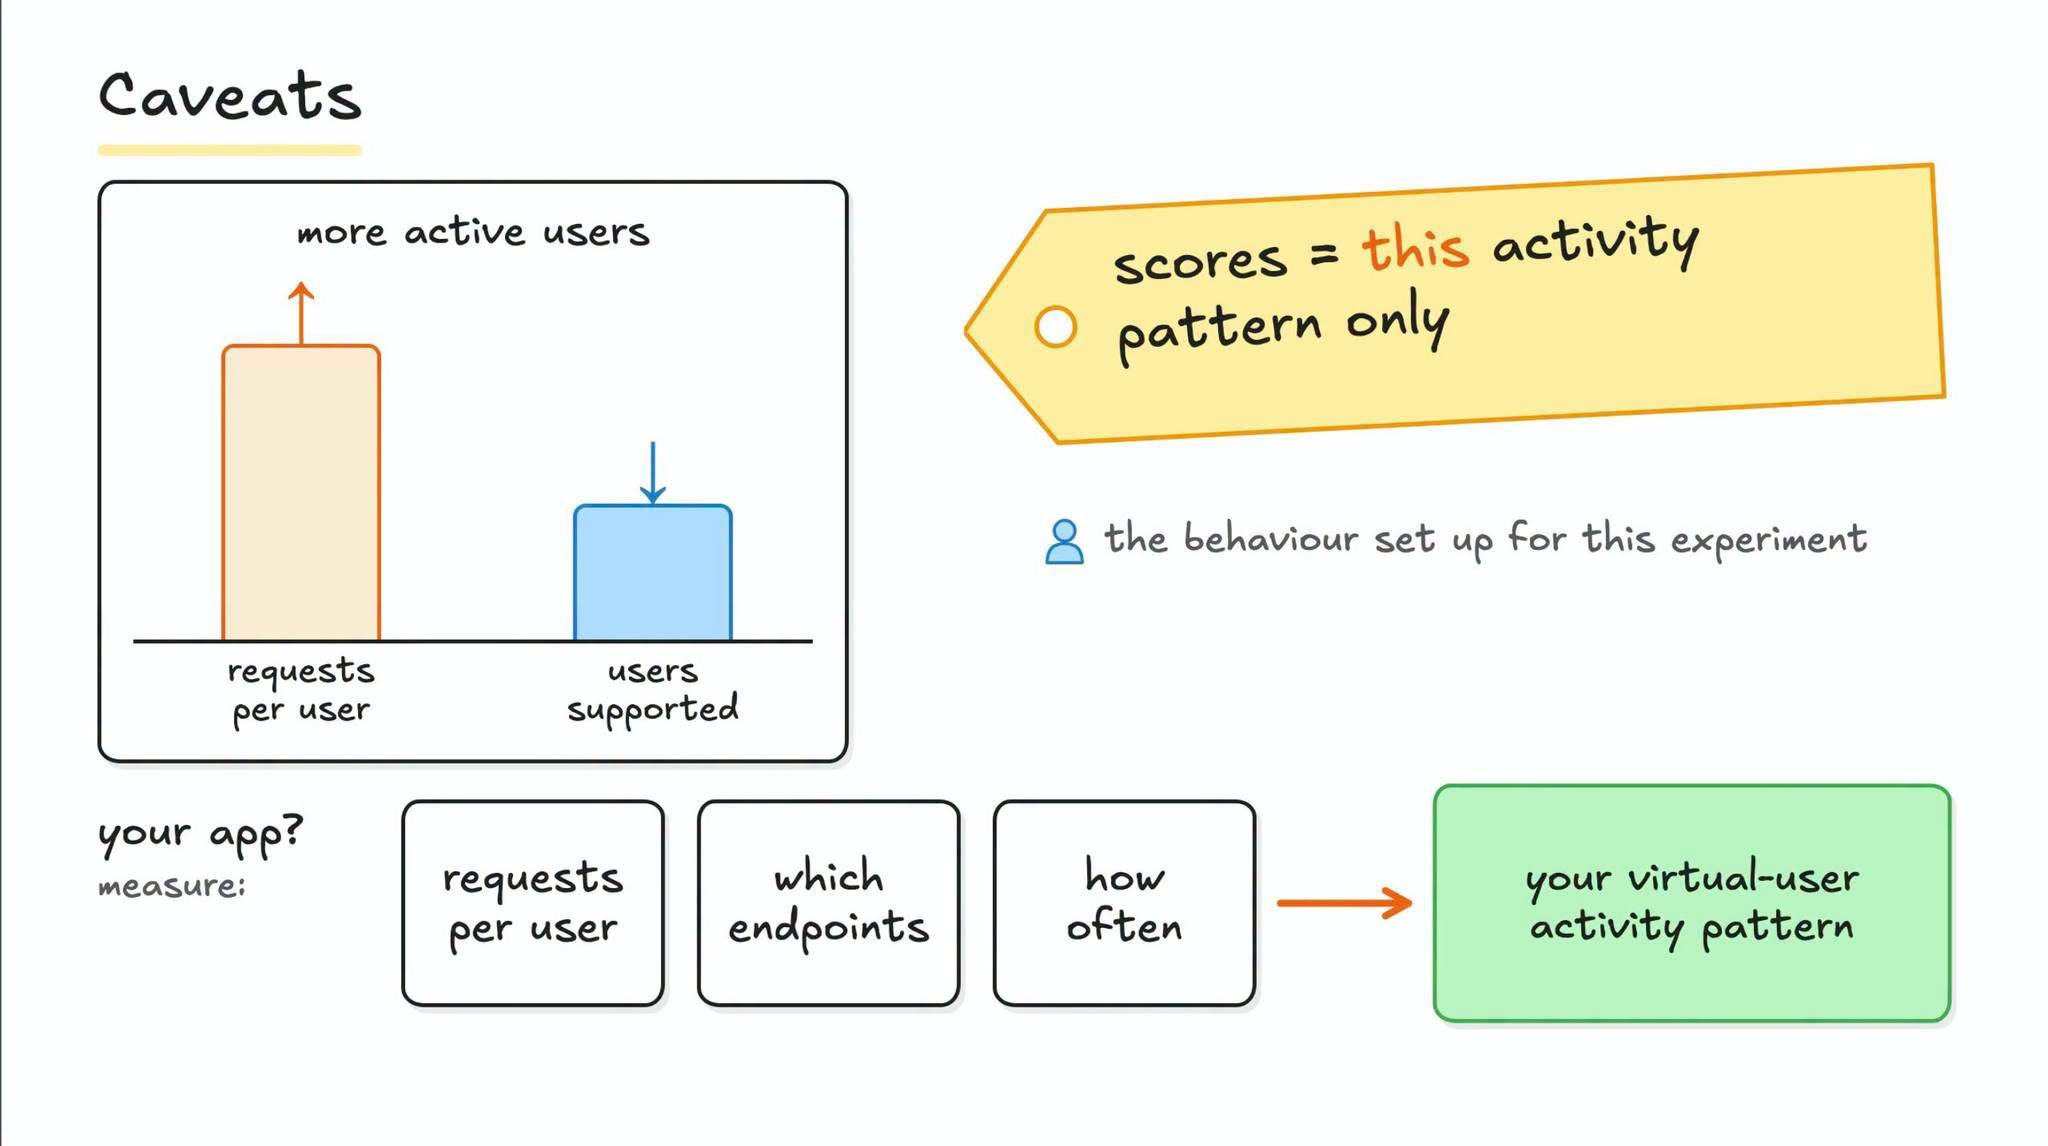
Vừa rồi mình có xem được một bài benchmark rất kỳ công của Arjay McCandless. Thay vì test những dòng code "Hello World" vô nghĩa để đua top framework, tác giả dựng hẳn một kịch bản Social Media API sát với thực tế: user giữ kết nối, đọc bài viết (read-heavy), có khoảng nghỉ giữa các lần lướt (think time), thỉnh thoảng tạo bài viết mới (write), và toàn bộ response đều bật Gzip compression.
 406414d9-35ba-802b-a6e2-ed3b8bc82abd.png
1. Thiết lập bài toán và tiêu chuẩn Pass/Fail
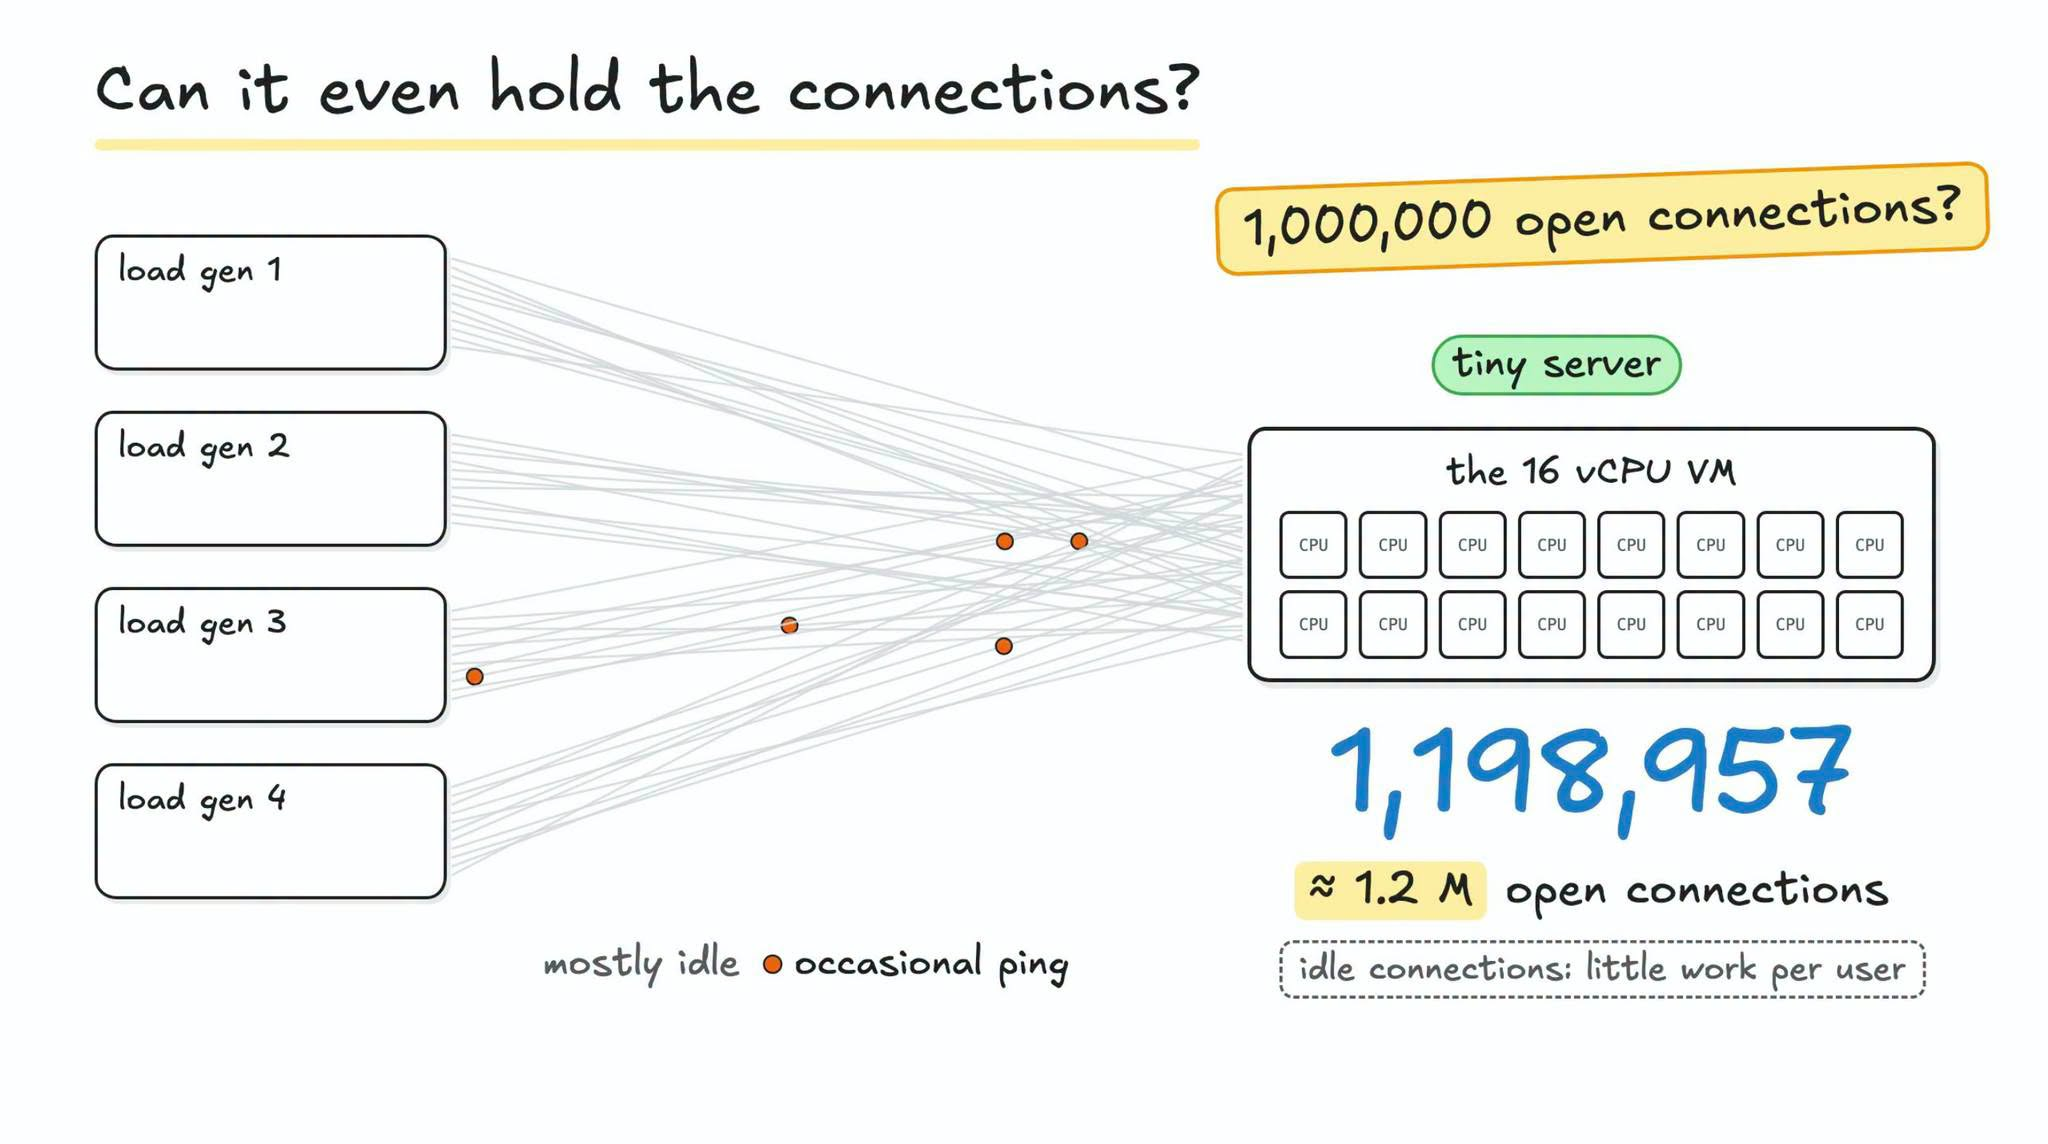
Cấu hình máy chủ thử nghiệm là một chiếc VM có 16 vCPUs, 32GB RAM (Intel Xeon Platinum 8260).
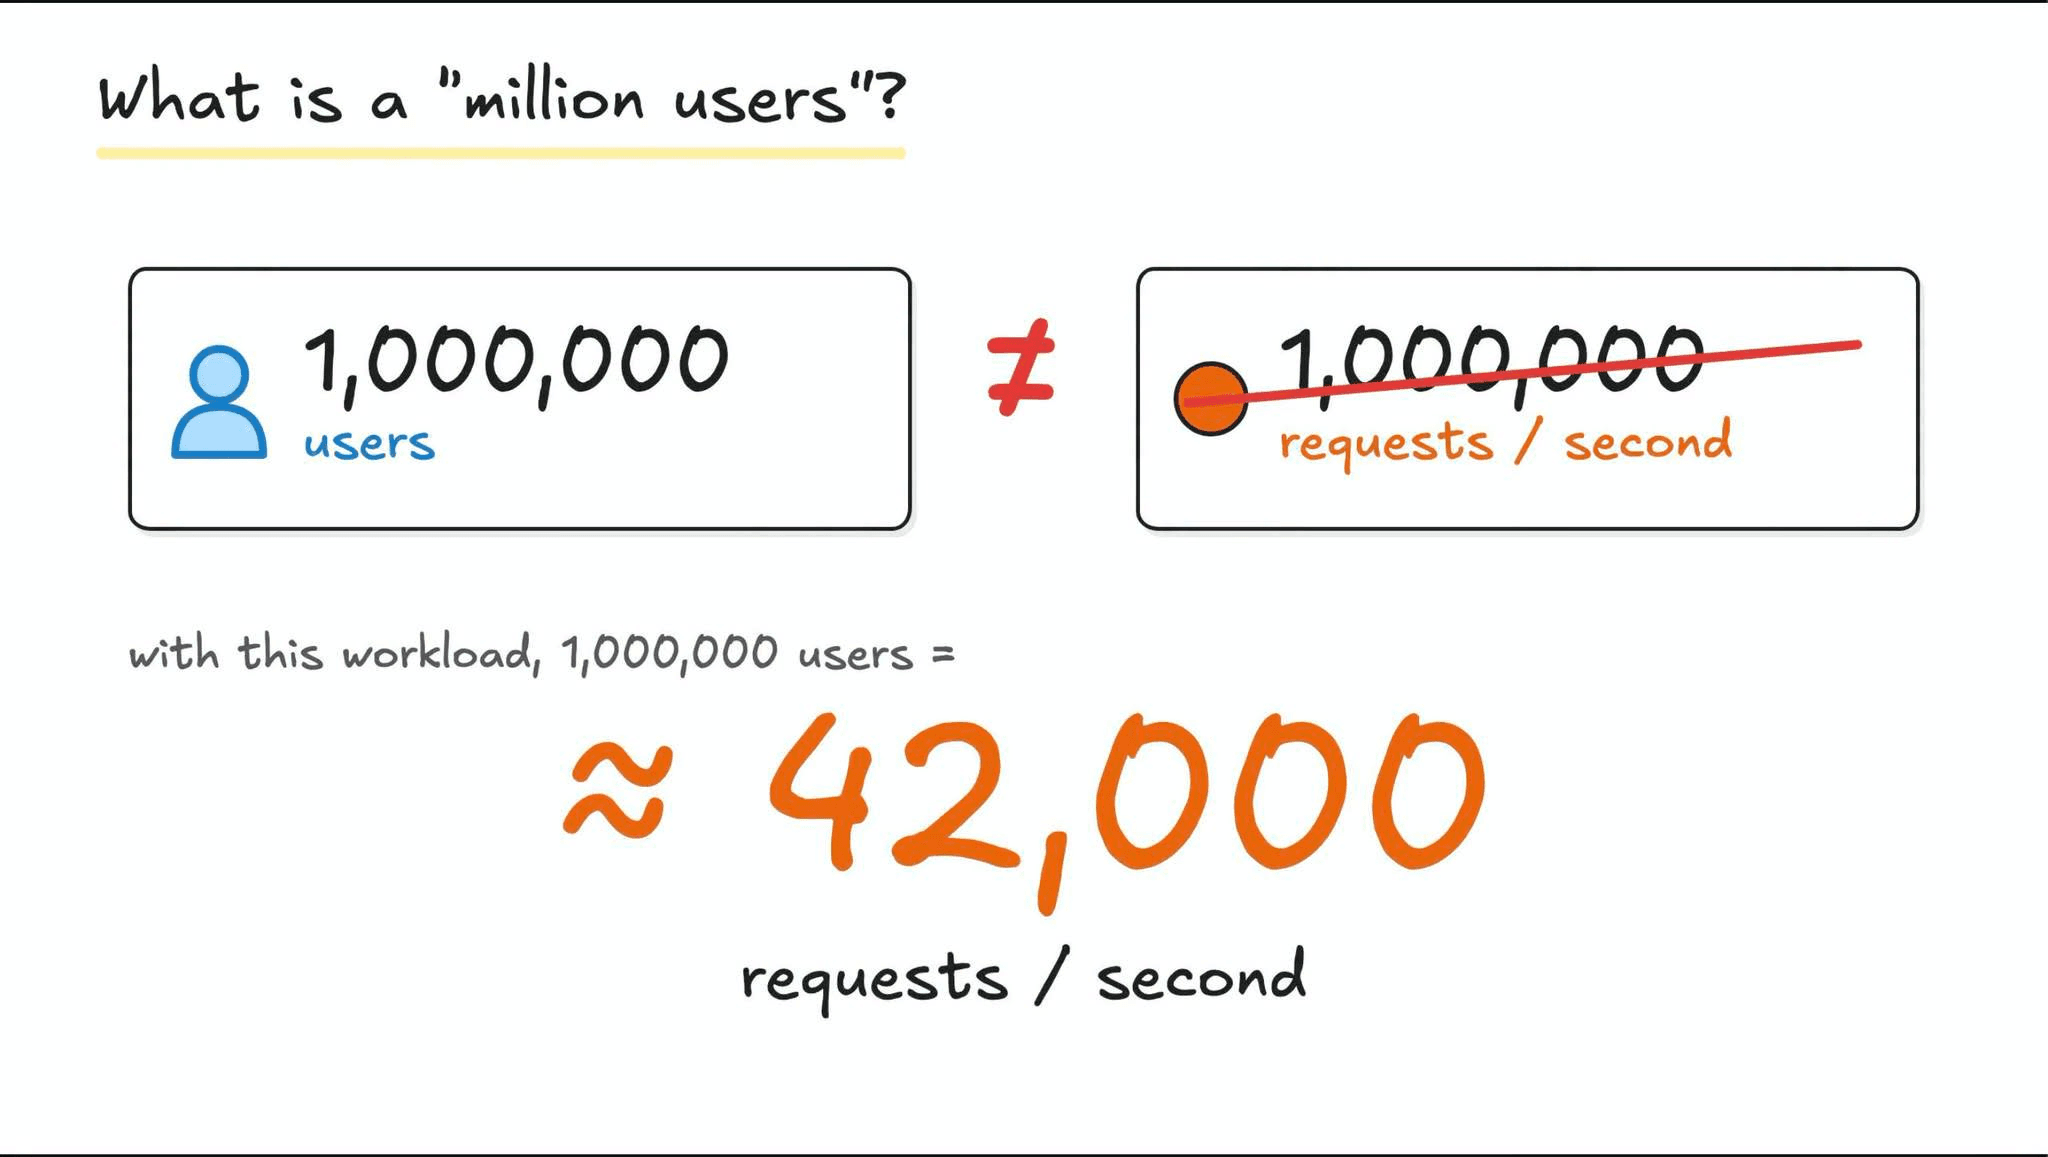
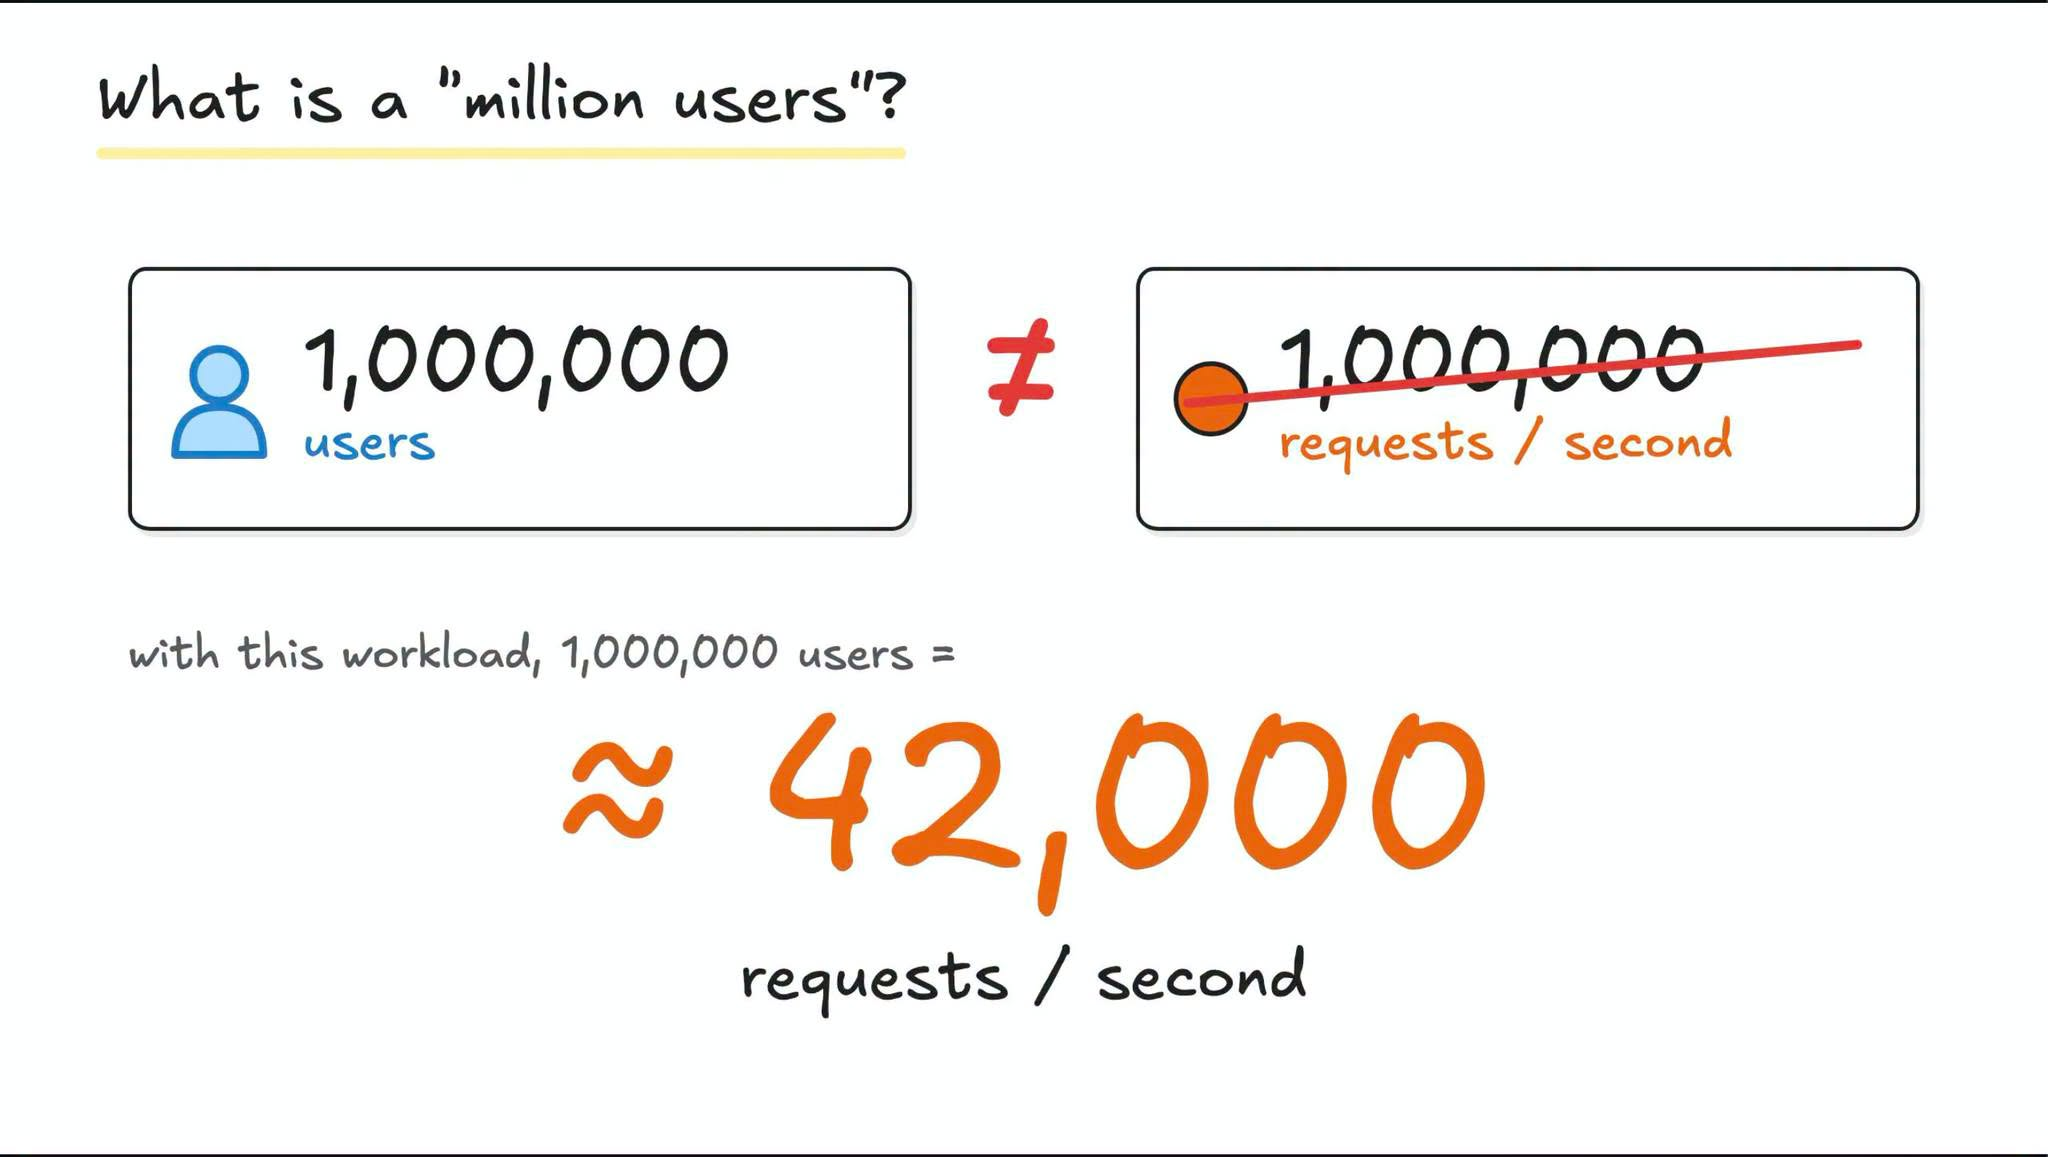
Khái niệm "1 triệu users" ở đây là 1 triệu simulated users đang kết nối đồng thời, tạo ra lưu lượng khoảng 42.000 requests/second. Trước khi vào bài test chính, tác giả đã kiểm chứng ở tầng OS/Network: con VM này hoàn toàn giữ được 1.2 triệu open connections chỉ với các lệnh ping nhẹ. Nghĩa là giới hạn sẽ nằm ở tầng Application và Database.
Điều kiện để một bài test được tính là Pass:
- Duy trì lượng user liên tục trong 5 phút.
- Latency p95 < 500ms và p99 < 1s.
- Tỷ lệ lỗi (Error rate) < 1%.
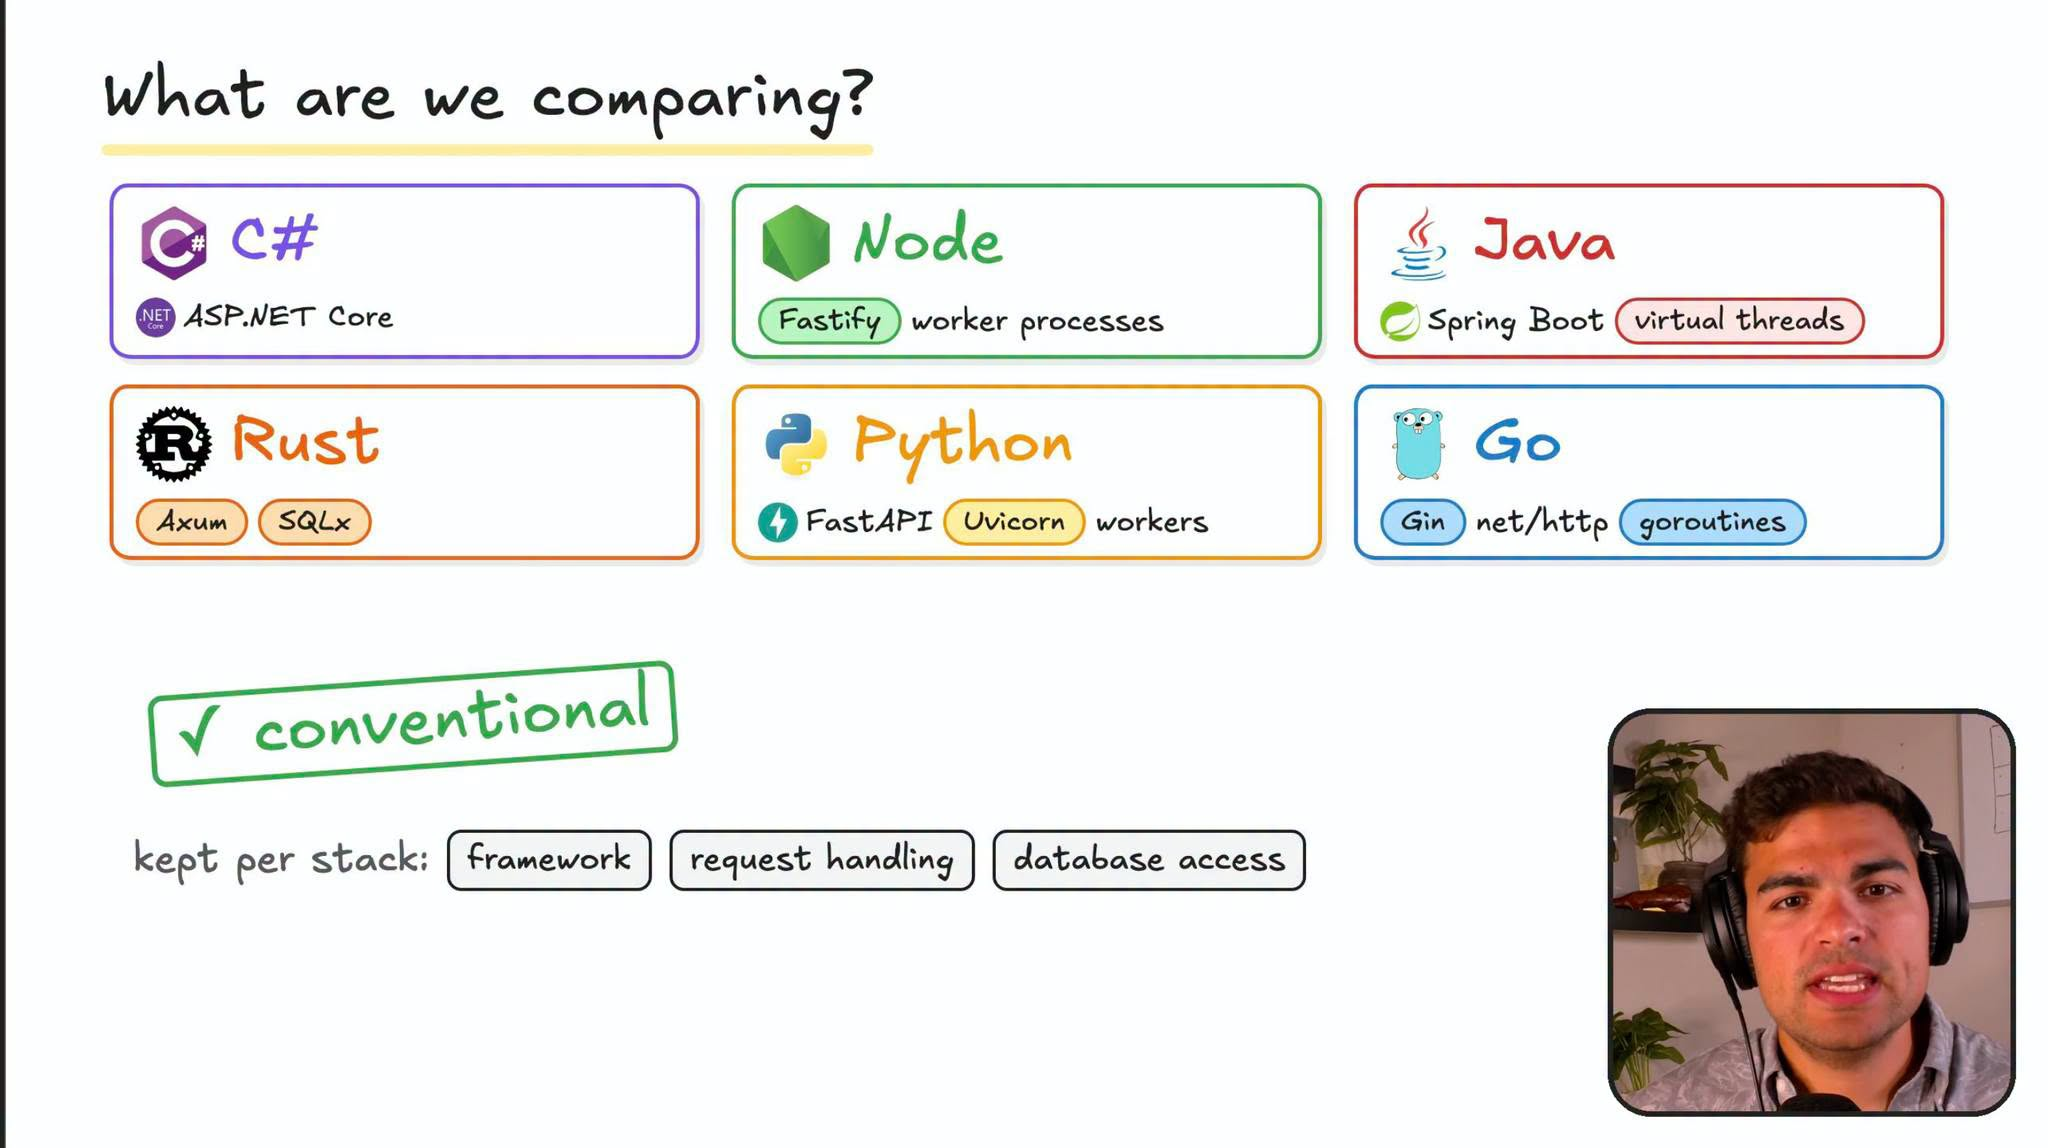
Các tech stack được đưa lên bàn cân đều là những gương mặt thân quen được cấu hình theo chuẩn thông thường:
- C#: ASP.NET Core
- Node.js: Fastify (chạy multi-worker processes để tận dụng đa nhân)
- Java: Spring Boot (đã bật Virtual Threads)
- Rust: Axum + SQLx
- Python: FastAPI (chạy multi-worker với Uvicorn)
- Go: Gin + Goroutines chuẩn
 406414d9-35ba-803c-b62b-f00862779035.png
2. Hiệp 1: Chạy chung với SQLite trên cùng 1 VM
Ở giai đoạn đầu, cả App và SQLite chạy chung trên một máy để loại bỏ hoàn toàn network latency khi gọi DB. Tác giả phải tắt tính năng memory accounting mặc định của một số bản build SQLite vì cơ chế shared bookkeeping gây ra internal lock contention rất nặng khi tăng số lượng CPU cores.
Khi chỉ cấp 1 CPU Core:
- Node.js bất ngờ dẫn đầu với 75.000 users.
- C#: 60.000 | Rust: 52.000 | Go: 50.000
- Java: 36.000 | Python: 35.000
Khi mở khóa toàn bộ 16 CPU Cores: Thứ tự bảng xếp hạng thay đổi đáng kể khi các runtime bắt đầu phát huy khả năng xử lý đa luồng, nhưng không một stack nào chạm tới mốc 1.000.000 users:
- C# (ASP.NET Core): Đứng đầu bảng với ~722.000 - 728.000 users.
- Node.js (Fastify): Đạt 665.000 users.
- Java (Spring Boot): Tăng vọt từ 36k lên 550.000 users (mức độ scale theo core cực kỳ ấn tượng).
- Rust (Axum): Đạt 535.000 users.
- Python (FastAPI): Đạt 420.000 users.
- Go (Gin): Gây bất ngờ lớn khi chỉ dừng lại ở 198.000 users.
Một chi tiết thú vị với C# và SQLite: Khi tác giả thử tinh chỉnh sâu hơn vào GC settings, điều phối luồng ghi và cơ chế WAL checkpoint của SQLite, C# đã gánh được tới 900.000 users trong 2 phút đầu. Tuy nhiên, đến phút thứ 5 thì quá trình SQLite checkpoint (đồng bộ dữ liệu từ Write-Ahead Log về lại file DB chính) gây ra hiện tượng stall, đẩy latency vượt ngưỡng cho phép và trượt bài test.
 406414d9-35ba-808e-86c3-c1b60d42ef22.png
3. Hiệp 2: Tách PostgreSQL sang một Server riêng biệt
Vì SQLite chỉ cho phép single writer tại một thời điểm và dễ bị nghẽn lúc checkpoint, tác giả quyết định chuyển sang kiến trúc chuẩn Production: tách Database sang một máy chủ riêng chạy PostgreSQL (đã cấu hình Connection Pool, Prepared Statements và tắt tính năng Memoize của query planner do ngốn quá nhiều CPU).
Theo lý thuyết, việc giải phóng toàn bộ gánh nặng I/O và CPU của Database khỏi Application Server sẽ giúp App chịu tải tốt hơn. Nhưng kết quả thực tế ở 16 cores lại đi ngược hoàn toàn với trực giác của nhiều anh chị em:
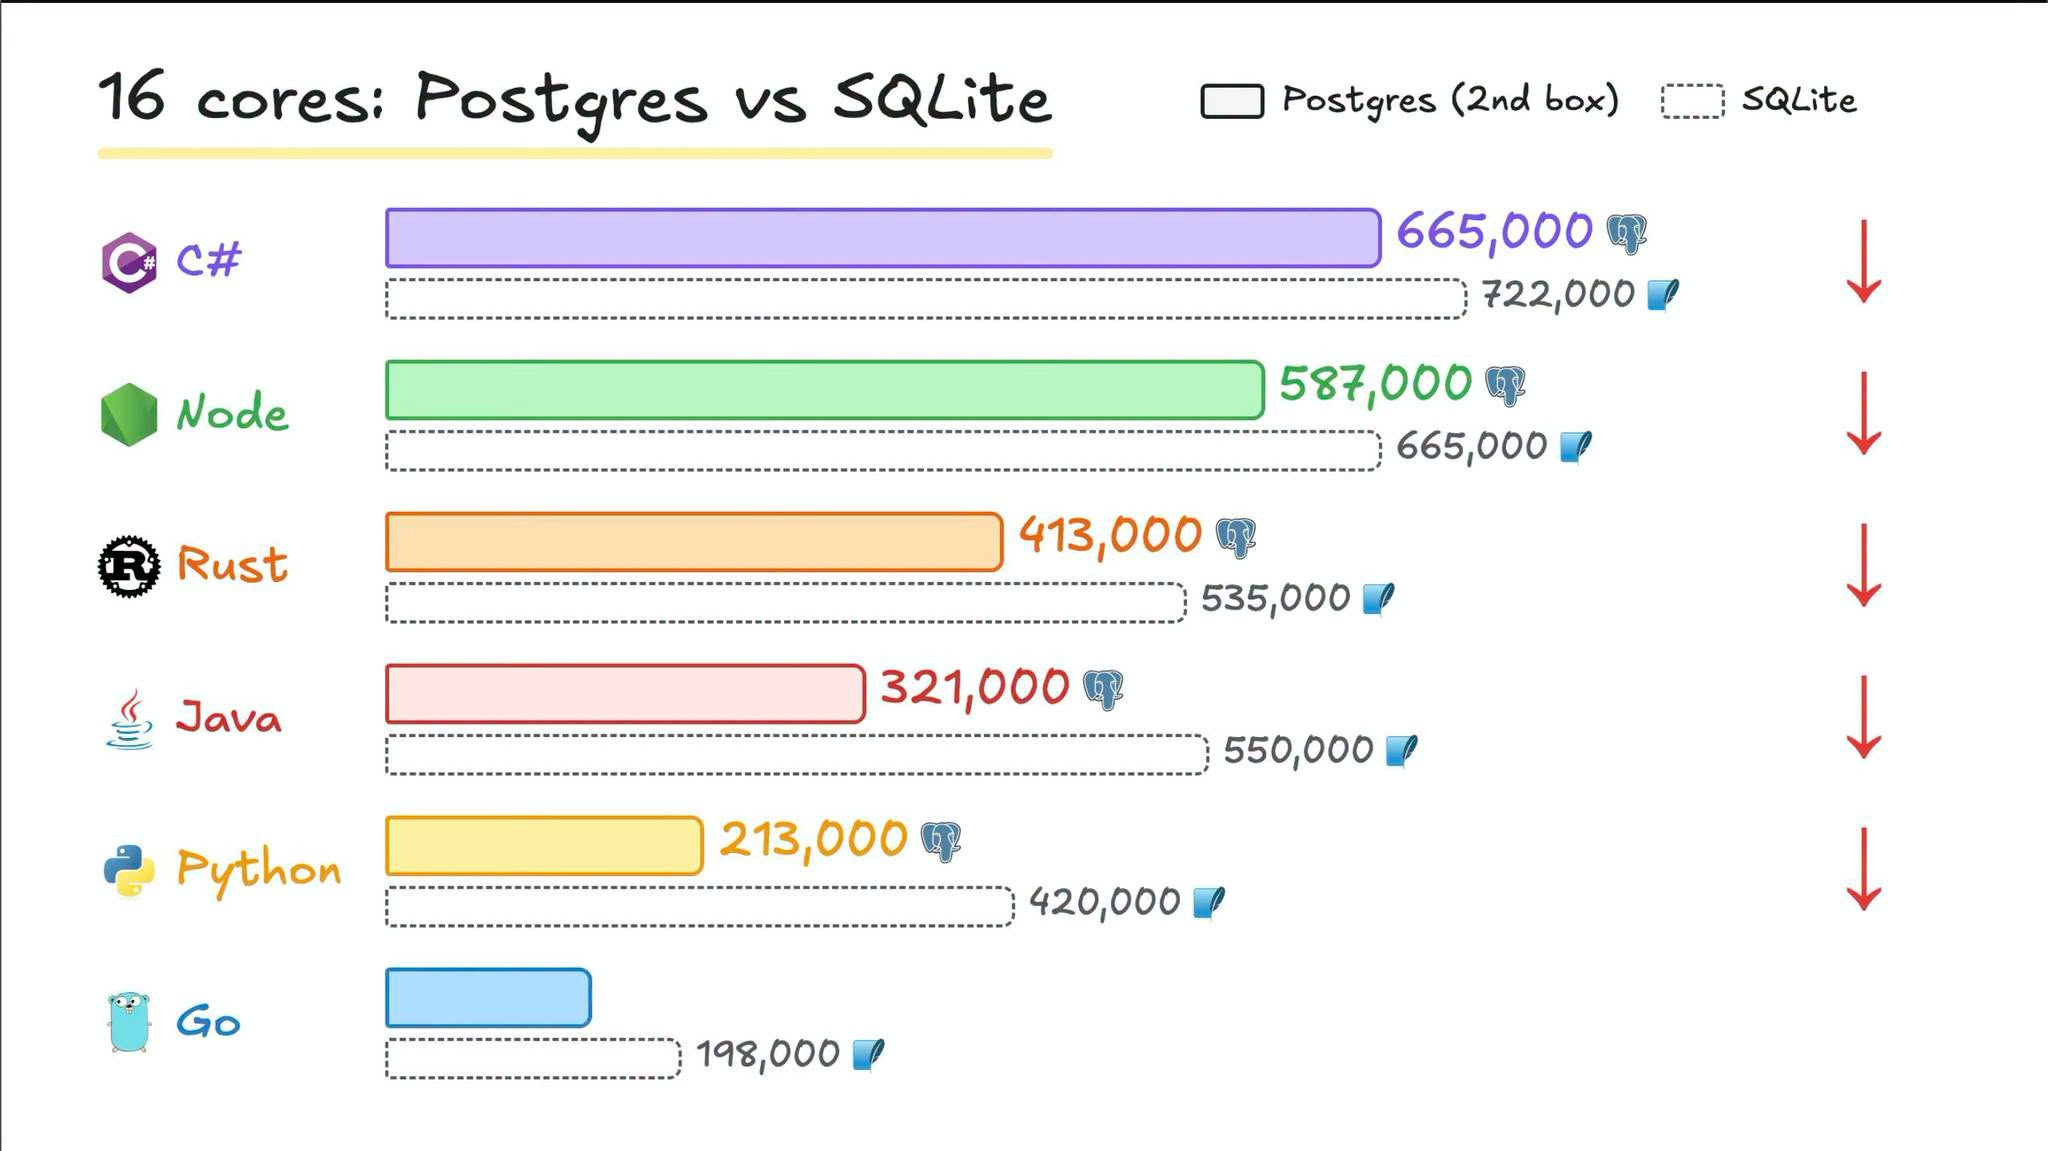
- C#: Giảm từ 722k xuống 665.000 users.
- Node.js: Giảm từ 665k xuống 587.000 users.
- Rust: Giảm từ 535k xuống 413.000 users.
- Java: Tụt mạnh từ 550k xuống chỉ còn 321.000 users.
- Python: Giảm từ 420k xuống 213.000 users.
- Go: Nhích nhẹ từ 198k lên 248.000 users.
Tại sao thêm máy chủ Database riêng mà hiệu năng tổng thể lại tụt? Lý do là khi giao tiếp qua mạng với một DB độc lập, bài toán chuyển dịch sang độ trễ mạng, cách DB driver xử lý bất đồng bộ, quản lý connection pool và đặc biệt là thời gian một request phải "nằm chờ" trong bộ nhớ của Application.
 406414d9-35ba-803f-a7a5-c1cdc4418d60.png
 406414d9-35ba-80ed-828d-d0c0565ab90a.png
4. Đi tìm nút thắt cổ chai (Bottlenecks) và màn lội ngược dòng
Điểm đáng giá nhất của video nằm ở phần mổ xẻ lý do tại sao Go và Java gần như "dậm chân tại chỗ" khi tăng gấp đôi CPU từ 8 cores lên 16 cores (Go chỉ nhích từ 236k lên 248k, còn Java từ 312k lên 321k).
Cú lội ngược dòng của Go (Từ 248k vọt lên 650k users):
- Thủ phạm thứ nhất - Gzip Middleware: Trong thư viện Gzip middleware đang dùng, mỗi khi có request đi vào, nó lập tức cấp phát một bộ compression writer tốn khoảng 1MB RAM ngay cả trước khi request chạm tới handler. Khi lượng request bị ứ đọng (back up), hàng loạt writer này cùng tồn tại trong bộ nhớ. RAM phình to khiến Garbage Collector (GC) phải chạy liên tục -> làm chậm toàn bộ ứng dụng -> request càng ứ đọng nhiều hơn -> tạo thành một vòng lặp chết (death spiral) trong khi DB bên kia lại đang rảnh rỗi chờ việc.
- Thủ phạm thứ hai - TCP Keep-Alive Probes: Việc kiểm tra kết nối định kỳ trên hàng trăm nghìn connections cùng lúc tạo ra một lượng overhead khổng lồ.
- Giải pháp: Chỉ cần đổi thư viện compression middleware khác và tắt TCP keep-alive probes, biểu đồ của Go lập tức dựng đứng: từ 248.000 vọt lên 650.000 users ở 16 cores.
Bài học về Virtual Threads trên Java Spring Boot
- Nhiều anh em nghĩ bật Virtual Threads (Project Loom) là có thể thoải mái xử lý hàng triệu concurrent requests mà không lo tốn OS threads. Điều đó đúng về mặt lập lịch CPU, nhưng bản thân mỗi request đang bay (in-flight work) và các connection processing buffers đi kèm vẫn ngốn bộ nhớ Heap.
- Khi DB trả về chậm hơn tốc độ request đổ vào, các buffers này nhanh chóng lấp đầy Heap. Một khi Heap chạm trần, GC chạy hết công suất cũng không thu hồi đủ vùng nhớ trống, làm ứng dụng bị nghẽn hoàn toàn. Tăng thêm CPU cores lúc này là vô nghĩa vì hệ thống đang đói RAM chứ không đói CPU.
- Khi tác giả tăng giới hạn Heap allowance lên, Java tăng lên được 340.000 users. Thử tăng kích thước Database Connection Pool trong trường hợp của Java thậm chí còn làm kết quả tệ đi, vì nó cho phép nhiều dữ liệu tràn vào vùng nhớ của App cùng lúc hơn, càng đẩy Heap nhanh chạm đáy.
Ngược lại, với C# và Node.js
- Với C#, khi nâng giới hạn Connection Pool của Postgres lên 256, điểm số ở 16 cores tăng từ 665k lên 700.000 users (quản lý vùng nhớ của .NET trong kịch bản này tỏ ra rất hiệu quả).
- Với Node.js, sau khi tinh chỉnh lại tốc độ connection ramp-up (tránh việc nhồi kết nối mới quá gắt làm vọt latency p99 lúc khởi đầu), điểm số ở 16 cores với Postgres đã chạm mốc 639.000 users.
5. Đúc kết góc nhìn Kỹ thuật
Nhìn vào toàn bộ quá trình thử nghiệm này, có mấy điểm rất đáng để anh em chúng ta suy ngẫm khi thiết kế và tối ưu hệ thống:
- Đừng vội đổ lỗi cho ngôn ngữ hay Framework: Việc Go ban đầu chỉ đạt 198k users không phải vì Go chậm, mà chỉ vì một cái Gzip middleware cấp phát bộ nhớ chưa tối ưu. Một cấu hình sai ở tầng middleware hoặc network có thể xóa sạch mọi lợi thế của ngôn ngữ.
- Concurrency không miễn phí về mặt bộ nhớ: Dù bạn dùng Goroutines hay Java Virtual Threads, mỗi kết nối đang mở và mỗi request đang chờ I/O đều giữ lại các vùng nhớ đệm (buffers). Ở quy mô hàng trăm nghìn kết nối, Memory Pressure và Garbage Collection mới là thứ giết chết throughput đầu tiên chứ không phải CPU.
- Tách tầng kiến trúc luôn đi kèm chi phí: Đưa Database ra khỏi máy chủ ứng dụng là bắt buộc để scale về lâu dài, nhưng nó lập tức biến các lệnh gọi hàm nội bộ thành bài toán quản trị I/O mạng và Connection Pool.
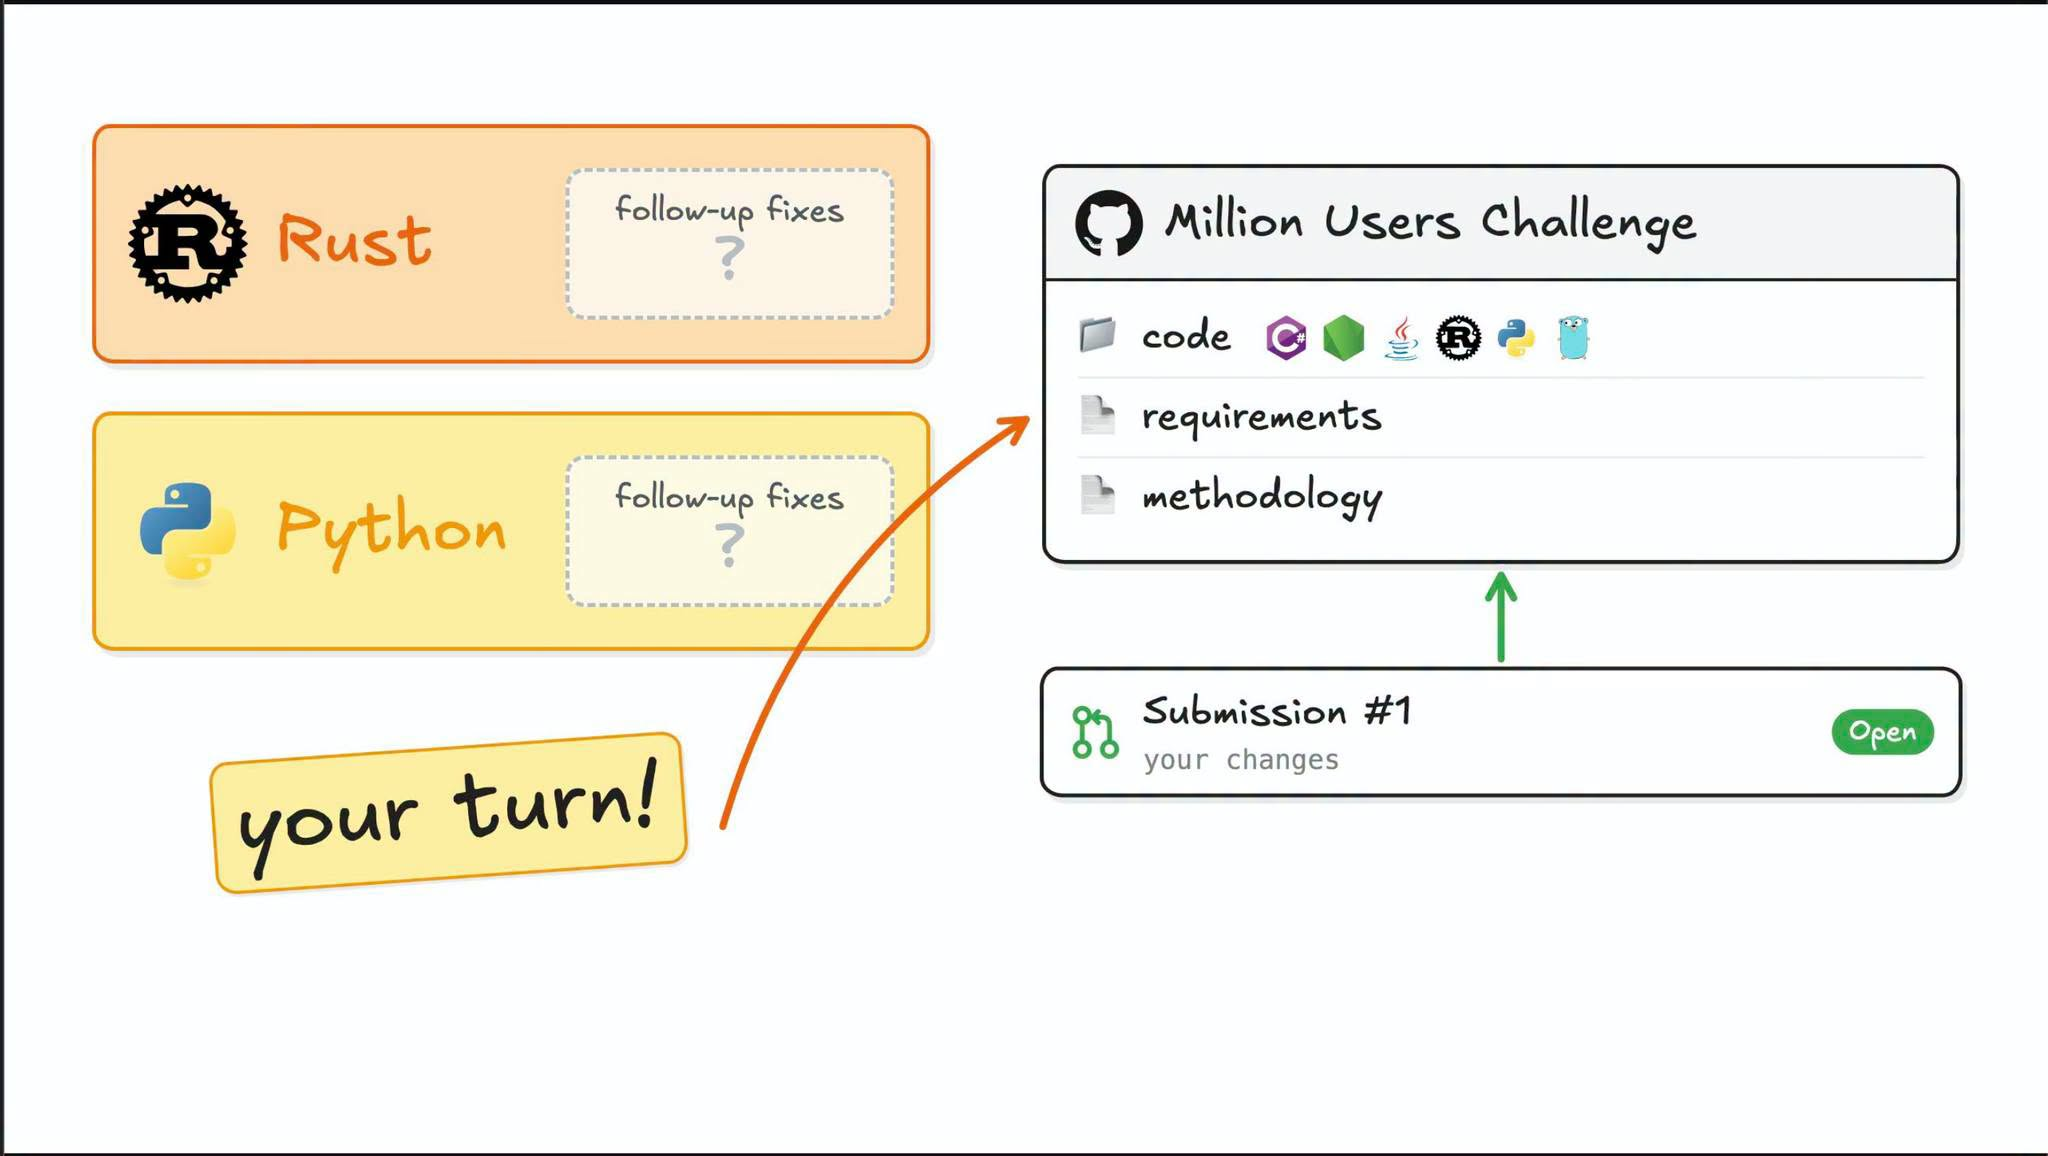
Hiện tại tác giả đã mở mã nguồn của toàn bộ bài benchmark này trên GitHub để cộng đồng cùng nhảy vào tối ưu xem ai có thể đưa các stack chạm mốc 1.000.000 users trên 16 cores (hoặc thậm chí 8 cores).
 406414d9-35ba-8098-868a-e90d731a0934.png
Trong dự án thực tế của mọi người, khi hệ thống bắt đầu chạm ngưỡng tải cao, nút thắt đầu tiên mà anh chị em thường đụng phải là gì? Do Database, cạn kiệt Connection Pool, hay bị GC pause do tràn bộ nhớ? Cùng chia sẻ dưới phần bình luận nhé!